Déployer un service IA sur Kubernetes avec Helm
Conteneuriser une API d'inférence FastAPI → Gemini, écrire son chart Helm de zéro (sondes, ressources, HPA, PDB, NetworkPolicy, non-root), la charger jusqu'à déclencher l'autoscaling et la mettre à jour sans perdre une requête.
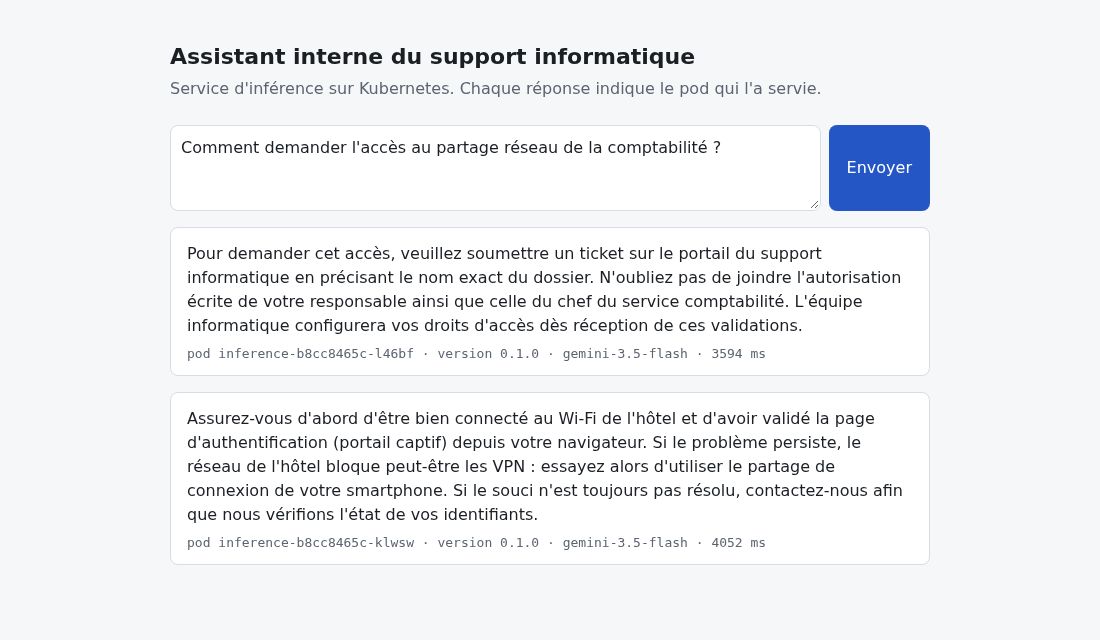
Ferrand Médical, distributeur de matériel médical (900 salariés), a mis en service un assistant interne pour son support informatique : les salariés posent leur question (« mon VPN ne se connecte pas depuis l'hôtel »), Gemini répond en trois phrases. Le prototype tournait dans un conteneur sur une VM. Il est tombé deux fois en un mois : une fois à cause d'une fuite mémoire jamais redémarrée, une fois parce que le déploiement d'une nouvelle version a coupé le service pendant quatre minutes, un lundi à 9 h. L'équipe plateforme exploite déjà Kubernetes pour d'autres applications et demande que l'assistant y entre avec les mêmes garanties que le reste.
Ce projet construit ce service de bout en bout et le prouve sur un vrai cluster local.
Ce que vous livrez
- Une API d'inférence FastAPI qui appelle Gemini, avec sondes de santé, délestage en surcharge, métriques Prometheus et journaux JSON.
- Une image non-root de 174 Mo, compatible avec un système de fichiers en lecture seule.
- Un chart Helm écrit de zéro : Deployment, Service, Ingress, ConfigMap, HPA, PodDisruptionBudget, NetworkPolicy, ServiceAccount sans jeton. La clé Gemini n'y figure jamais : elle vit dans un Secret créé à part.
- Des tests : 18 tests sans clé (API et rendu du chart avec
helm template), un test de bout en bout sur le cluster, un test de charge mesuré. - Une procédure de mise à jour et de retour arrière validée sous charge : 68 993 requêtes, zéro erreur, à travers une mise à jour, une version cassée et un rollback.
Architecture
flowchart LR
  U["Navigateur / curl"] -->|"http://assistant.127.0.0.1.nip.io:8081"| ING["Ingress NGINX (nœud control-plane)"]
  subgraph KIND["Cluster kind lab-k8s-ia"]
    ING --> SVC["Service inference"]
    SVC --> P1["Pod API (worker)"]
    SVC --> P2["Pod API (worker2)"]
    HPA["HPA 2 → 6 pods"] -.->|"CPU via metrics-server"| P1
    NP["NetworkPolicy"] -.-> P1
    SEC["Secret inference-gemini (créé par kubectl)"] -.-> P1
    CM["ConfigMap (modèle, limites)"] -.-> P2
  end
  P1 -->|"HTTPS 443"| G["API Gemini"]
  P2 -->|"HTTPS 443"| G
Stack
| Couche | Choix | Pourquoi |
|---|---|---|
| API | FastAPI 0.141, uvicorn, google-genai 2.31 | asynchrone : un pod attend Gemini sans bloquer les autres requêtes |
| Modèle | gemini-3.5-flash (clé d'API), gemini-2.5-flash sur Vertex AI | variable MODEL, aucune valeur en dur |
| Cluster | kind 0.33, Kubernetes 1.37, 3 nœuds | gratuit, jetable, assez réaliste pour tester PDB et répartition |
| Entrée | Ingress NGINX controller-v1.15.1 | demandé par l'équipe plateforme ; retiré par le projet Kubernetes, voir leçon 2 |
| Packaging | Helm 3.19 | une release versionnée = un retour arrière en une commande |
| Mise à l'échelle | HPA autoscaling/v2 + metrics-server 0.9.0 | CPU en lab ; métrique « requêtes en cours » expliquée pour la production |
Coût et durée
| Poste | Coût |
|---|---|
| Cluster kind | 0 € (local, 3 conteneurs Docker, 1,8 Go de RAM mesurés au pic de charge) |
make e2e | 1 appel Gemini Flash : une fraction de centime |
make load | 0 appel (backend fake, le test mesure Kubernetes, pas Gemini) |
| Ressources cloud | aucune |
Durée : 6 heures, dont 15 minutes de construction de cluster et d'images.
Prérequis
- Avoir déjà écrit un Deployment et un Service à la main, et lu des journaux avec
kubectl logs. - Docker avec 4 Go de RAM libres,
kind,kubectl,helm3, Python 3.10+. - Une clé d'API Gemini (Google AI Studio). Le port 8081 de la machine doit être libre.
Programme
| Leçon | Ce qui avance | Commande qui marche à la fin |
|---|---|---|
| 1. L'API d'inférence et son image | API, sondes, délestage, métriques, image non-root | make test vert |
| 2. Le cluster kind et l'Ingress | cluster 3 nœuds, Ingress NGINX, metrics-server | kubectl get nodes : 3 nœuds Ready |
| 3. Le chart Helm, écrit de zéro | templates, values, Secret hors chart, tests de rendu | make up puis make e2e vert |
| 4. Sondes, ressources, sécurité | sondes, requests/limits, non-root, PDB, NetworkPolicy | NetworkPolicy vérifiée par make e2e |
| 5. Autoscaling et test de charge | HPA CPU mesuré, métrique custom, un 502 diagnostiqué | make load : 2 → 6 pods |
| 6. Mise à jour progressive et rollback | rolling update, version cassée, helm rollback, nettoyage | make down : cluster supprimé |
Le dépôt complet est dans files/ : make help liste les commandes.
الموارد
تنزيل الكل (.zip)المراجع
- kind : Ingress (configuration du cluster et des ports)kind.sigs.k8s.io
- Kubernetes : Horizontal Pod Autoscalingkubernetes.io
- Kubernetes : sondes liveness, readiness et startupkubernetes.io
- Kubernetes : Network Policieskubernetes.io
- Kubernetes : PodDisruptionBudgetkubernetes.io
- Helm : bonnes pratiques des chartshelm.sh
- Retrait d'Ingress NGINX (blog Kubernetes, novembre 2025)kubernetes.io — Plus de correctifs de sécurité après mars 2026 : à remplacer par une implémentation Gateway API en production