MLflow pour les applications LLM : suivi, évaluation, registre, traces
Un serveur MLflow 3.17 auto-hébergé (PostgreSQL et stockage d'artefacts sous Docker Compose) pour un assistant RH Gemini : prompts versionnés avec alias, évaluations mlflow.genai avec règles et juge LLM, porte de promotion, modèle enregistré avec alias champion, traçage automatique des appels Gemini et comparaison dans l'interface.
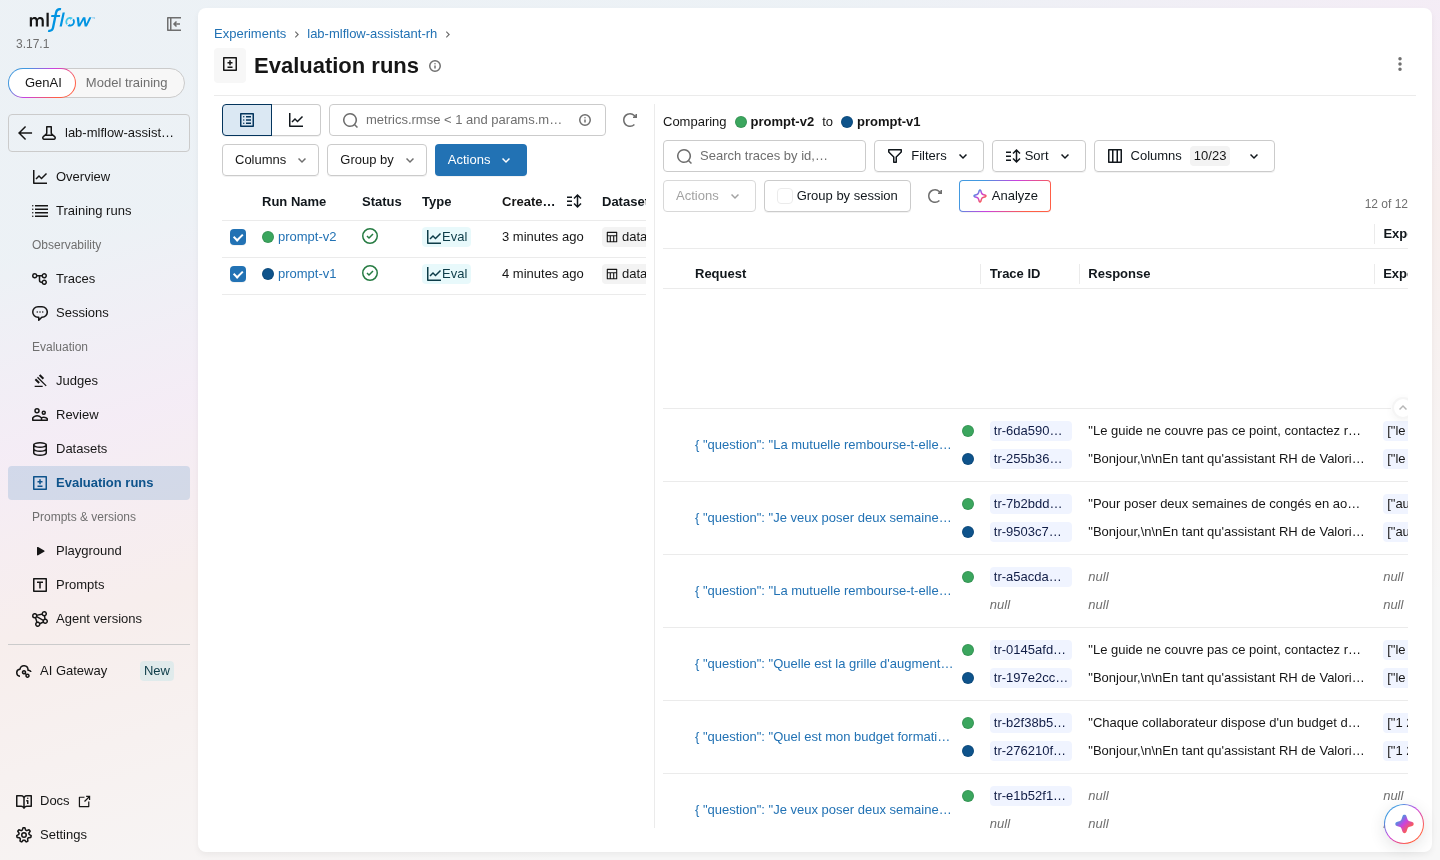
Valoria Mutuelle (entreprise fictive, 1 100 collaborateurs) a mis en ligne un assistant RH interne : une question en langage courant, une réponse tirée du guide des collaborateurs. Trois semaines plus tard, le service RH remonte deux réponses fausses sur les notes de frais. L'équipe découvre qu'elle ne sait dire ni quel prompt a produit ces réponses, ni si la nouvelle version écrite entre-temps fait mieux ou moins bien, ni combien d'appels Gemini échouent chaque jour. Le prompt est une constante dans le code, l'évaluation est un tableur, les appels ne laissent aucune trace.
Ce projet installe MLflow comme poste de contrôle de l'assistant : chaque version de prompt est enregistrée et désignée par un alias, chaque version est évaluée sur le même jeu par des règles et un juge LLM, la promotion suit une règle écrite, et chaque appel à Gemini est tracé. Tout tourne sur votre poste ; seul Gemini est appelé à distance.
Ce que vous livrez
- Une pile
docker compose -p lab-mlflow: MLflow 3.17.1, PostgreSQL 16, volume d'artefacts, démarrée et arrêtée parmake up/make downvérifiés. - Un registre de prompts avec deux versions et les alias
productionetprevious; l'assistant charge toujoursprompts:/lab-assistant-rh@production. - Une évaluation
mlflow.genai.evaluatesur 10 questions : deux règles déterministes et le jugeCorrectness. - Une porte de promotion : aucune régression, au moins un gain, sinon l'alias ne bouge pas.
- Un modèle « models from code » dans le registre de modèles, alias
champion, qui relit le prompt par alias au lieu de le figer. - Des traces de chaque appel Gemini, reprises sur 429 comprises, reliées à la version du prompt.
Architecture
flowchart LR
  subgraph Poste["Votre poste"]
    LAB["lab.py<br/>register, evaluate, promote, package"] --> AS["assistant.py<br/>answer()"]
    AS -- "mlflow.gemini.autolog()" --> G["Gemini<br/>clé d'API ou Vertex AI"]
  end
  subgraph Pile["docker compose -p lab-mlflow"]
    SRV["mlflow server :5050<br/>--serve-artifacts"] --> PG[("PostgreSQL 16<br/>runs, prompts, traces")]
    SRV --> ART[("volume artifacts<br/>modèles, tableaux d'éval")]
  end
  LAB -- "HTTP" --> SRV
  AS -- "load_prompt(@production)<br/>traces" --> SRV
Stack, coût, durée
| Élément | Choix | Pourquoi |
|---|---|---|
| Suivi | MLflow 3.17.1, image officielle + pilote psycopg | prompts, évaluations, traces et modèles dans un seul outil |
| Stockage | PostgreSQL 16 + volume d'artefacts servi par le serveur | écritures concurrentes de l'évaluation parallèle ; voir leçon 1 pour SQLite |
| Modèle | gemini-3.5-flash (clé d'API) ou gemini-2.5-flash (Vertex AI europe-west1) | même code, choisi par variables d'environnement |
| Juge | Correctness de mlflow.genai, sur le même modèle | vérifie les faits attendus du jeu |
Coût mesuré d'un make e2e : 20 réponses évaluées, 20 appels de juge, une question finale, soit une quarantaine d'appels Gemini et moins d'un centime. Durée : 5 h de lecture et de pratique ; make e2e a pris entre 2 min 19 s et 3 min 20 s le 2026-10-16, selon le nombre de 429 sur le quota partagé.
Prérequis
- Python et Docker courants ; avoir déjà appelé Gemini depuis Python.
- Docker Compose v2, le port 5050 libre.
- Une clé d'API Gemini, ou
gcloud auth application-default loginet un projet avec Vertex AI. - Sans clé :
make up,make test(8 tests, SQLite temporaire, faux Gemini) et l'exploration de l'interface restent possibles.
Programme
| # | Leçon | Vous finissez avec |
|---|---|---|
| 1 | Le serveur MLflow et son stockage | make up et make down vérifiés |
| 2 | Le registre de prompts et ses alias | deux versions, alias production, chargement par alias |
| 3 | Tracer les appels Gemini | une trace par question, reprises sur 429 visibles |
| 4 | Évaluer avec mlflow.genai | deux runs d'évaluation comparables |
| 5 | Porte de promotion et registre de modèles | alias déplacés par une règle, modèle champion |
| 6 | Comparer, exploiter, nettoyer | make e2e vert, comparaison dans l'interface, make clean vérifié |
Le dépôt complet est dans files/ ; commencez par son README.
الموارد
- example.env.example1 KB
- pyassistant_model.py1 KBعرض
- pyassistant.py3 KBعرض
- ymldocker-compose.yml1 KBعرض
- pylab.py10 KBعرض
- mdREADME.md2 KBعرض
- txtrequirements.txt1 KBعرض
- pyscorers.py2 KBعرض