Observabilité d'une application IA avec OpenTelemetry, Prometheus et Grafana
Instrumenter un assistant Gemini et un agent ADK selon les conventions gen_ai, faire passer métriques, traces et journaux par un collecteur OpenTelemetry vers Prometheus, Tempo et Loki, provisionner Grafana en code avec ses alertes, puis basculer l'export vers Cloud Monitoring et Cloud Trace.
Observabilité d'une application IA avec OpenTelemetry, Prometheus et Grafana
Ondine Télécom (opérateur fictif, 350 conseillers) a mis en service un assistant IA pour son support client : une route qui répond aux questions fréquentes avec Gemini et un cache, et un agent ADK qui diagnostique la ligne d'un client. Un lundi matin, les réponses passent de deux à six secondes et la facture de la semaine a pris 40 %. La supervision en place voit des réponses HTTP 200. Personne ne peut dire si le modèle ralentit, si le cache ne sert plus ou si l'agent boucle.
Ce projet construit l'observabilité qui répond en cinq minutes : chaque appel au modèle mesuré selon les conventions OpenTelemetry gen_ai (durée, tokens, erreurs), le coût et le taux de cache en métriques applicatives, des traces qui montrent chaque étape de l'agent, des journaux reliés à ces traces, un tableau de bord et trois alertes provisionnés en code. Puis le même code exporté vers Google Cloud en changeant un seul fichier.
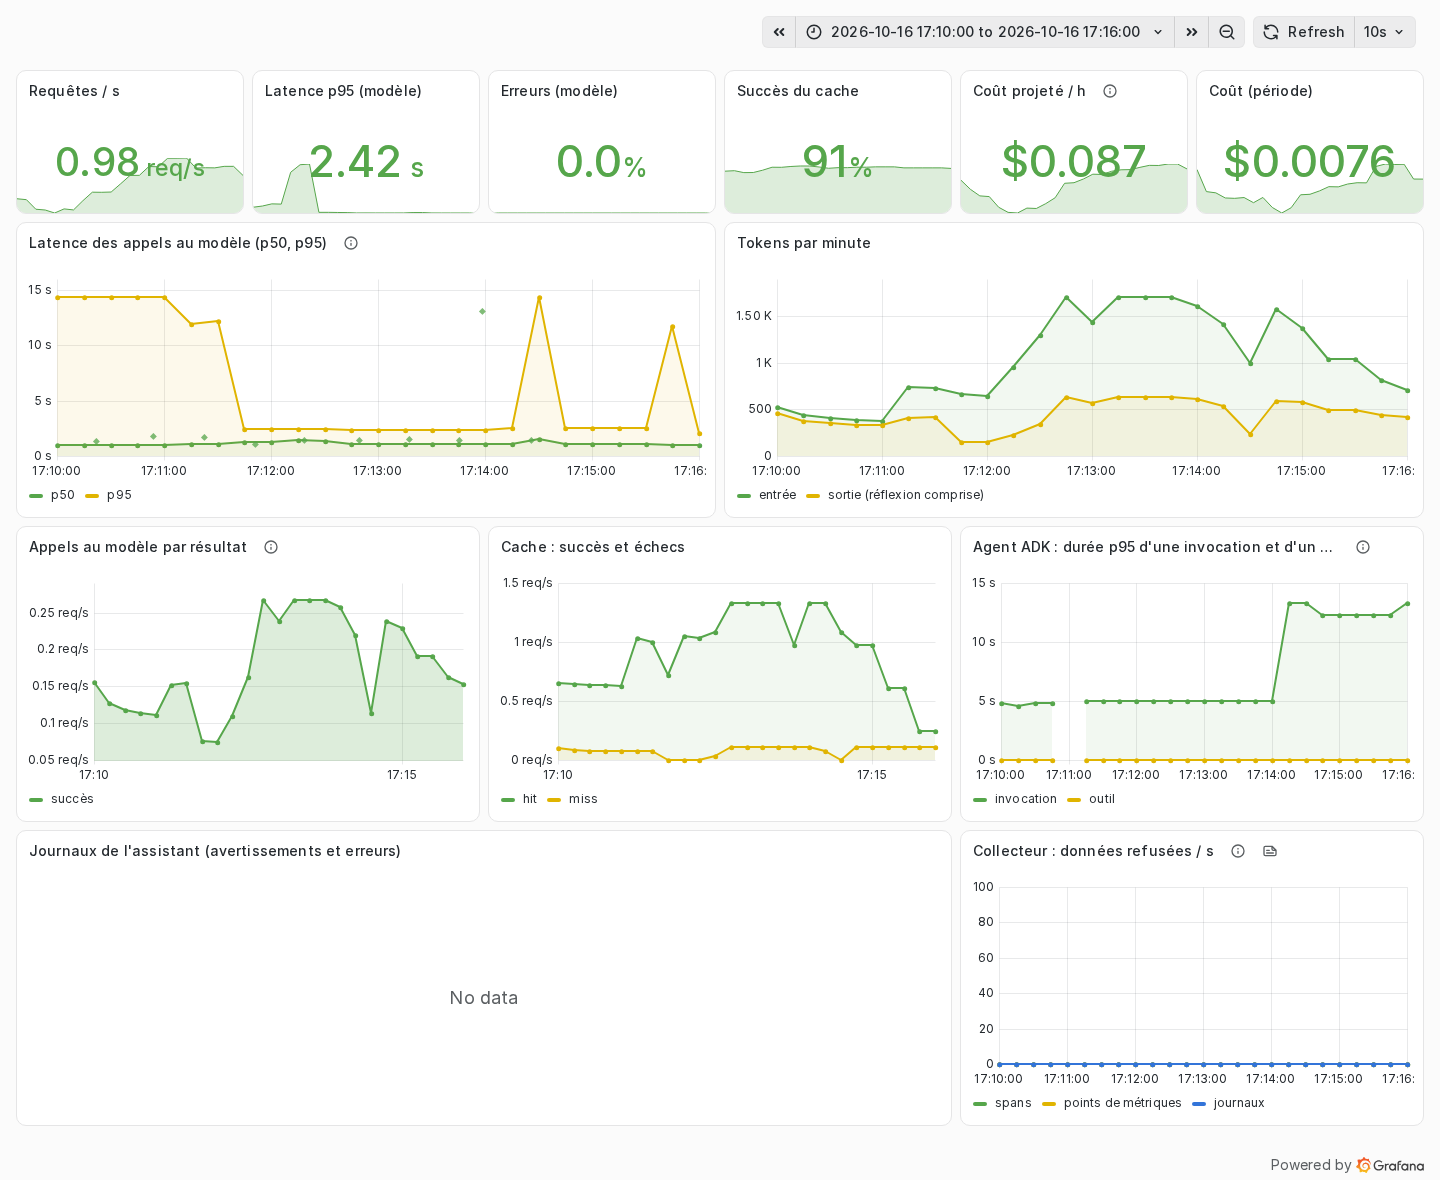
Capture réelle du 2026-10-16, pendant une charge de cinq minutes sur Vertex AI (gemini-3.5-flash-lite). Les losanges du graphe de latence ouvrent la trace de l'appel mesuré.
Ce que vous livrez
| Livrable | Où le voir |
|---|---|
Une pile collecteur OpenTelemetry, Prometheus, Tempo, Loki, Grafana (docker compose -p lab-otel) | leçon 1, make up |
Un service FastAPI dont chaque appel au modèle produit un span chat et les métriques gen_ai.* | leçon 2 |
| Coût estimé, taux de cache, agent ADK avec ses métriques natives et ses tokens | leçon 3 |
| Un tableau de bord de 13 panneaux généré par script, avec exemplars, traces et journaux reliés | leçon 4, make e2e |
| Trois alertes provisionnées, déclenchées volontairement par une charge de test | leçon 5, make demo-alerte |
| La configuration du collecteur pour Cloud Monitoring, Cloud Trace et Cloud Logging, validée | leçon 6, make valider-gcp |
Architecture
flowchart LR
  subgraph APP["Service assistant-support (FastAPI, port 8088)"]
    Q["/question<br/>cache + Gemini"]
    A["/agent<br/>agent ADK + outil"]
    SDK["SDK OpenTelemetry<br/>traces, métriques gen_ai, journaux"]
  end
  CH["Charge de test<br/>(loi de Zipf)"] --> Q
  CH --> A
  Q --> GEM["Gemini<br/>(clé API ou Vertex AI)"]
  A --> GEM
  Q --> SDK
  A --> SDK
  SDK -->|"OTLP/HTTP"| COL["Collecteur OTel<br/>memory_limiter, filtre, batch"]
  subgraph LAB["docker compose -p lab-otel"]
    COL --> PROM[("Prometheus")]
    COL --> TEMPO[("Tempo")]
    COL --> LOKI[("Loki")]
    GRAF["Grafana<br/>tableau de bord + alertes en code"]
  end
  GRAF --> PROM
  GRAF --> TEMPO
  GRAF --> LOKI
  COL -.->|"leçon 6 : collector-gcp.yaml"| GCP["Cloud Monitoring<br/>Cloud Trace, Cloud Logging"]
Stack et coût
| Élément | Choix | Pourquoi |
|---|---|---|
| SDK | OpenTelemetry Python 1.42.1 | plafond imposé par ADK 2.10 ; tout le SDK est aligné dessus |
| Conventions | gen_ai (dépôt semantic-conventions-genai, statut Development) | noms communs avec ADK et les outils du marché |
| Collecteur | opentelemetry-collector-contrib 0.161.0 | un point d'entrée, filtrage des contenus, changement de destination sans code |
| Stockages | Prometheus 3.15, Tempo 2.10, Loki 3.7 | ouverts, légers (moins de 1 Go de RAM pour la pile entière, Grafana compris) |
| Grafana | 13.1, provisionné en fichiers | tableau de bord et alertes relus en revue de code |
| Modèle | gemini-3.5-flash-lite | 0,30 USD / 2,50 USD par million de tokens entrée / sortie |
| Agent | Google ADK 2.10 | spans et métriques natifs, complétés par un callback |
Coût mesuré : make e2e (100 requêtes, 29 appels au modèle) a coûté 0,0039 USD le 2026-10-16 sur Vertex AI. make test et make demo-alerte utilisent un faux modèle et ne coûtent rien. La pile tourne en local ; aucune ressource Google Cloud n'est créée.
Prérequis
- Docker 24+ avec Compose v2, 2 Go de RAM libres, ports 3100, 3200, 3300, 4317, 4318, 8088 et 9095 disponibles.
- Python 3.10+,
make,openssl. - Pour les appels réels : une clé API Gemini, ou un projet Google Cloud avec Vertex AI (
gcloud auth application-default login). Sans l'un ni l'autre,FAUX_MODELE=1fait tout fonctionner sauf l'agent. - Avoir déjà écrit une API FastAPI et un agent ADK simple ; connaître les bases de PromQL aide pour le module 3.
Programme
| Module | Leçon | À la fin, cette commande marche |
|---|---|---|
| 1. Déployer | Collecteur, Prometheus, Tempo, Loki et Grafana en Docker Compose | make up → 5 conteneurs, Grafana prêt |
| 2. Instrumenter | Tracer et mesurer chaque appel au modèle selon les conventions gen_ai | make test → 10 tests verts |
| Coût, taux de cache et agent ADK : ce que la convention ne mesure pas | make run → réponse, cache, agent | |
| 3. Visualiser et alerter | Un tableau de bord Grafana provisionné en code, relié aux traces et aux journaux | make e2e → les trois signaux vérifiés |
| Alertes provisionnées et charge de test réelle | make demo-alerte → alerte « Firing » | |
| 4. Exploiter | L'export équivalent vers Cloud Monitoring et Cloud Trace, puis le nettoyage | make valider-gcp, make down vérifié |
الموارد
تنزيل الكل (.zip)المراجع
- Conventions sémantiques OpenTelemetry pour l'IA générativegithub.com
- Configuration du collecteur OpenTelemetryopentelemetry.io
- Grafana : provisionnement des sources et tableaux de bordgrafana.com
- Grafana : provisionner les alertes par fichiersgrafana.com
- Loki : ingestion OpenTelemetrygrafana.com
- Tempo : TraceQLgrafana.com
- ADK : observabilitégoogle.github.io
- Google Cloud : migrer le collecteur vers les exportateurs OTLPdocs.cloud.google.com