Un harness d'évaluation continue pour applications LLM
Construire le harness qui décide si un changement de modèle ou de prompt peut partir en production : jeu de données versionné, scorers enfichables dont un LLM-juge calibré, comparaison A/B avec intervalles de confiance, rapport HTML et porte de qualité en CI. Démonstration réelle : gemini-3.8-flash contre gemini-3.5-flash-lite.
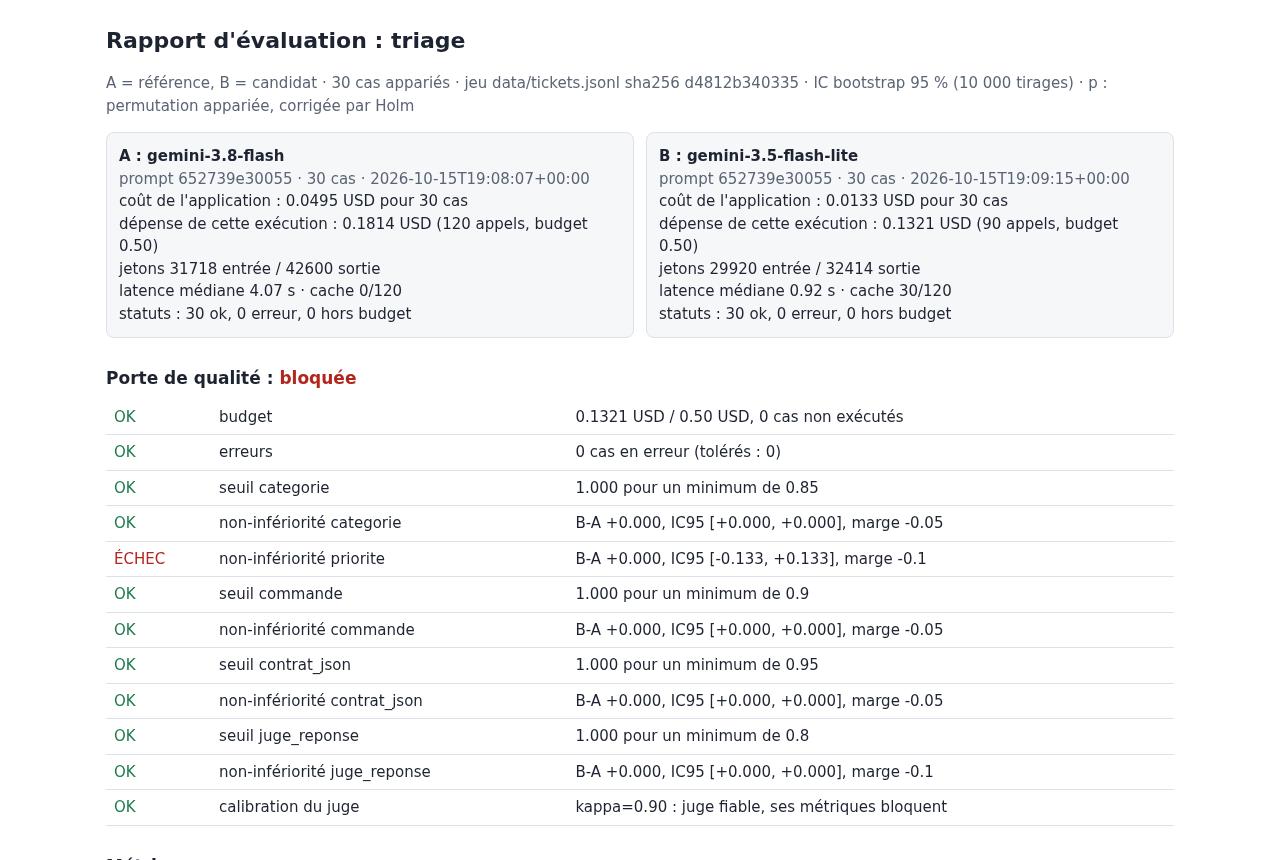
Le service client d'un vendeur en ligne trie 4 000 tickets par jour avec gemini-3.8-flash. La direction financière demande de passer à gemini-3.5-flash-lite, 3,7 fois moins cher sur cette tâche (mesuré plus bas). L'équipe a « essayé sur quelques tickets, ça a l'air pareil ». Trois semaines plus tôt, un raccourcissement du prompt qui « avait l'air pareil » avait fait promettre des remboursements immédiats à des clients, hors politique.
Ce projet construit l'outil qui répond à cette question avec des preuves : un harness d'évaluation continue, c'est-à-dire le code qui exécute une application LLM sur un jeu de cas versionné, note chaque sortie, compare deux versions avec une marge d'erreur chiffrée et bloque la fusion d'une pull request quand la qualité baisse.
Ce que vous livrez
Un dépôt Python d'environ 1 200 lignes, plus 380 lignes de tests, prêt à cloner (files/) :
| Brique | Ce qu'elle fait | Fichier |
|---|---|---|
| Jeu de données versionné | JSONL validé, empreinte SHA-256 canonique, manifeste vérifié en CI | dataset.py |
| Exécution | parallélisme borné, reprises sur 429/503, cache disque des sorties, budget en USD par exécution | runner.py, llm.py |
| Scorers enfichables | exact, regex, schéma JSON, similarité d'embeddings, LLM-juge à grille, trajectoire d'agent, et les vôtres par chemin d'import | scorers.py |
| Calibration du juge | kappa de Cohen entre le juge et 22 annotations humaines | cli.py |
| Comparaison | différences appariées, IC bootstrap 95 %, test de permutation, correction de Holm | stats.py, compare.py |
| Rapport | un fichier HTML autonome, diff des cas qui changent | report.py |
| Porte de qualité | non-infériorité par métrique, seuils, budget ; code de sortie pour la CI | github-actions.yml |
L'application évaluée est fictive mais réaliste : le support de Cyclone Pièces, vendeur en ligne de pièces de vélo. Elle a deux points d'entrée, un tri (classification, extraction, brouillon de réponse, un appel en sortie structurée) et un agent à trois outils (chercher une commande, rembourser, escalader) dont on évalue la trajectoire.
Architecture
flowchart LR
  D["data/*.jsonl + MANIFEST.json"] --> R["runner : pool de 4 fils"]
  S["suites/triage.yaml : cible, modèle, prompt, scorers, porte"] --> R
  R -->|"cache manquant"| M["MeteredClient : reprises, budget"]
  M --> G["Gemini API ou Vertex AI"]
  R <--> C[".cache/ : sorties, embeddings, verdicts"]
  R --> SC["scorers : exact, regex, schéma, embeddings, juge, trajectoire"]
  SC --> O["runs/X/results.jsonl + summary.json"]
  O --> CMP["compare : bootstrap, permutation, Holm"]
  K["calibration.json : kappa du juge"] --> CMP
  CMP --> H["rapport.html"]
  CMP --> P{"porte de qualité"}
  P -->|"0"| OK["fusion autorisée"]
  P -->|"1"| KO["PR bloquée"]
Le résultat de la démonstration (exécution réelle du 2026-10-15)
| gemini-3.8-flash (A) | gemini-3.5-flash-lite (B) | |
|---|---|---|
| Catégorie exacte | 1,000 | 1,000 |
| Priorité exacte | 0,867 | 0,867 |
| Numéro de commande, montant, contrat JSON | 1,000 | 1,000 |
| Réponse acceptable selon le juge calibré (kappa 0,90) | 1,000 | 1,000 |
| Coût de l'application pour 1 000 tickets | 1,65 USD | 0,44 USD |
| Latence médiane d'un tri | 4,07 s | 0,92 s |
| Verdict de la porte | bloquée : sur la priorité, IC 95 % de B − A = [−0,133 ; +0,133], marge tolérée −0,10 |
Les moyennes sont identiques, et la porte bloque quand même : sur 30 cas, les deux modèles se trompent sur des tickets différents, et l'échantillon ne permet pas d'exclure une dégradation de 13 points. La leçon 3.1 calcule qu'il faudrait environ 105 cas pour qu'un modèle réellement équivalent franchisse cette porte 8 fois sur 10.
Le lendemain, le 2026-10-16, la même démonstration relancée sur Vertex AI donne d'autres moyennes (priorité 0,867 contre 0,933, juge 1,000 contre 0,933) et la même décision, pour une autre raison : gemini-3.5-flash-lite y promet un remboursement de 249 € sans la validation exigée au-delà de 150 €. C'est le genre de réponse qu'un « ça a l'air pareil » ne donne jamais.
Stack
Python 3.10+, google-genai 2.31, numpy, jsonschema, pyyaml. Aucun framework d'évaluation : le module 3 explique quand en adopter un plutôt que ce code.
Coût et durée
| Poste | Mesuré le 2026-10-15 |
|---|---|
make test (30 tests) | 0 USD, 1 seconde, sans clé |
make calibrate (22 verdicts du juge) | 0,08 USD |
make run (2 modèles × 30 cas, juge et embeddings compris) | 0,31 USD |
make e2e (calibration + tri + agent) | 0,42 USD (API Gemini) ; 0,43 USD et 13 min 36 s sur Vertex AI le 2026-10-16, au tarif de l'API Gemini |
| Relance à l'identique | 0 USD : tout vient du cache |
| Ressources Google Cloud créées | aucune (appels d'API uniquement) |
Durée : 7 heures environ, dont 1 heure de lecture des rapports.
Prérequis
- Python professionnel (typage,
concurrent.futures, pytest). - Avoir déjà appelé Gemini en sortie structurée ; notions de base de statistique (moyenne, écart-type, ce qu'est une p-valeur).
- Une clé Gemini (Google AI Studio), ou un projet Vertex AI avec identifiants ADC et
GOOGLE_CLOUD_LOCATION=global.
Programme
| Module | Leçon | Vous repartez avec |
|---|---|---|
| 1. Cadrer | Décider sur des preuves | l'architecture, le dépôt installé, make test vert |
| Un jeu de données versionné | 30 cas conçus pour discriminer, empreinte et manifeste | |
| 2. Exécuter et noter | Exécution parallèle, cache et budget | le runner, le coût par cas, la première exécution réelle |
| Scorers déterministes et trajectoires d'agent | exact, regex, schéma, trajectoire, scorer maison | |
| Similarité et LLM-juge calibré | une grille, un juge, un kappa de 0,90 mesuré | |
| 3. Décider et automatiser | Comparer deux versions | bootstrap, permutation, Holm, non-infériorité, taille d'échantillon |
| La porte de qualité en CI | le workflow GitHub Actions, une PR bloquée pour de bonnes raisons | |
| Construire ou adopter | promptfoo, Inspect, OpenAI Evals, DeepEval, ADK, MLflow : quand les préférer |
En local ou sur Google Cloud
Le code appelle l'API Gemini avec une clé (GOOGLE_API_KEY) ou Vertex AI (GOOGLE_GENAI_USE_VERTEXAI=TRUE) sans modification. Sur Vertex AI, le 2026-10-15, seul le point d'accès global servait les trois modèles utilisés ; europe-west1 renvoyait 404 pour gemini-3.8-flash, gemini-3.5-flash-lite et gemini-embedding-2. Si vos données doivent rester en Europe, c'est une contrainte de choix de modèle à trancher avant l'évaluation, pas après.
Recursos
Descargar todo (.zip)Referencias
- Adding Error Bars to Evals (Miller, 2024)arxiv.org — Intervalles de confiance, comparaisons appariées, taille d'échantillon : la base statistique du module 3
- Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena (Zheng et al., 2023)arxiv.org — Biais de position, de verbosité et d'auto-préférence des LLM-juges
- Tarifs de l'API Geminiai.google.dev — Prix utilisés par le compteur de budget, relevés le 2026-10-15
- Sortie structurée (API Gemini)ai.google.dev
- Évaluation des agents dans ADKadk.dev
- Inspect (UK AI Security Institute)inspect.aisi.org.uk
- promptfoopromptfoo.dev
- MLflow : évaluation des applications GenAImlflow.org