Vertex AI Pipelines pour un cycle LLM reproductible
Un pipeline KFP v2 qui prépare un jeu de référence, évalue un prompt Gemini candidat contre la version en production, enregistre métriques et artefacts dans Vertex ML Metadata et Experiments, puis ne promeut le candidat que s'il passe une porte explicite : cache, paramètres, planification et nettoyage vérifié.
Le support informatique d'Assurances Ventoux, mutuelle de 900 collaborateurs (entreprise fictive), route chaque jour environ 400 tickets internes vers cinq files : accès, matériel, logiciel, paie, achats. Le routage est fait par Gemini avec un prompt de quinze lignes. En septembre, quelqu'un a « amélioré » ce prompt un vendredi soir ; le lundi, les demandes de renouvellement de licence partaient en file logiciel, où personne ne valide de devis. Il a fallu deux jours pour retrouver quelle version tournait, sur quel jeu on l'avait testée, et avec quel score.
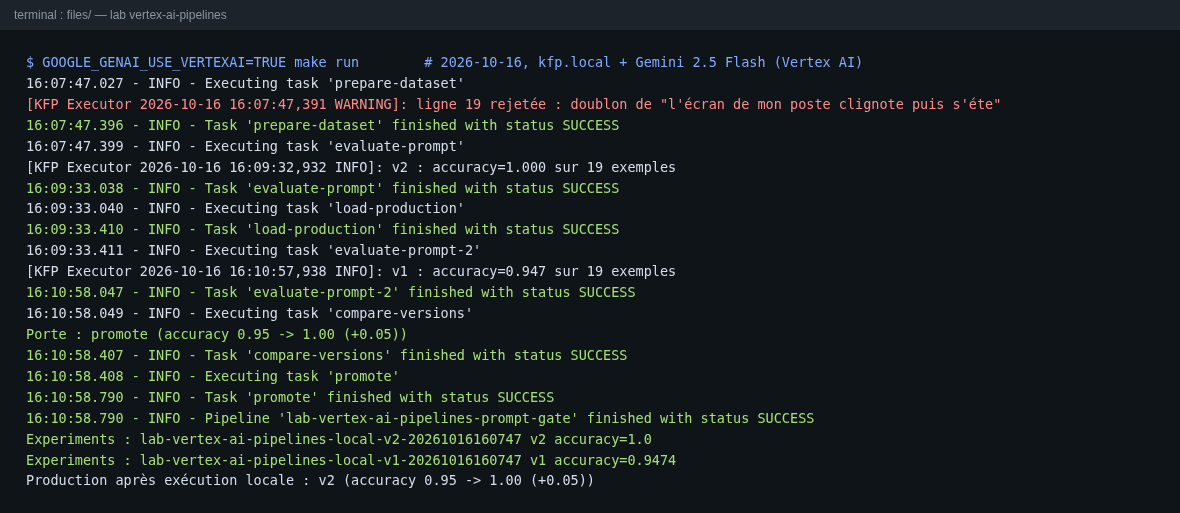
La demande : qu'aucun prompt n'arrive en production sans avoir battu la version en place sur un jeu de référence, et que l'on puisse dire, pour chaque version, qui l'a évaluée, sur quelles données, avec quel résultat. Ce projet construit ce circuit sous la forme d'un pipeline Kubeflow (KFP v2) exécutable sur votre poste et sur Vertex AI Pipelines.
Ce que vous livrez
- Cinq composants KFP v2 testés sans réseau : préparation du jeu, lecture de la production, évaluation Gemini, porte de promotion, promotion avec historique.
- Un pipeline compilé en YAML, versionnable, soumis tel quel à Vertex AI Pipelines.
- Des métriques (exactitude, latence médiane, tokens, échecs) et une matrice de confusion enregistrées comme artefacts ML Metadata, et une ligne par évaluation dans Vertex AI Experiments.
- Un cache maîtrisé : ce qui doit être recalculé l'est, ce qui ne doit jamais l'être (la lecture du registre, la promotion) ne l'est pas.
make cloud-up,make e2e,make cloud-down: création du bucket, exécution réelle, suppression vérifiée.
Architecture
flowchart LR
  REF[("data/reference.jsonl<br/>20 tickets étiquetés")] --> PREP["prepare-dataset<br/>validation, dédoublonnage, empreinte"]
  REG[("registre<br/>production.json")] --> LOAD["load-production<br/>jamais en cache"]
  PREP --> EC["evaluate-prompt<br/>candidat v2"]
  PREP --> EP["evaluate-prompt-2<br/>production v1"]
  LOAD --> EP
  EC -- "metrics" --> GATE{"compare-versions<br/>seuil, gain, échecs"}
  EP -- "metrics" --> GATE
  GATE -- "promote" --> PROM["promote<br/>production.json + history/"]
  PROM --> REG
  EC -. "artefacts" .-> MD[("Vertex ML Metadata<br/>+ Experiments")]
  EP -. "artefacts" .-> MD
Stack, coût, durée
| Élément | Choix | Pourquoi |
|---|---|---|
| Orchestration | KFP 2.17 (SDK), Vertex AI Pipelines (exécution) | DAG versionné, artefacts tracés sans code de suivi |
| Exécution locale | kfp.local.SubprocessRunner | même DAG, sans Docker ni projet, pour itérer en quelques minutes |
| Modèle évalué | gemini-2.5-flash sur Vertex AI europe-west1 (ou gemini-3.5-flash avec une clé d'API) | sortie contrainte à une énumération de cinq files |
| Registre | un fichier JSON sur Cloud Storage, monté sous /gcs/ | suffisant pour un prompt ; historique conservé |
| Composants Google | google-cloud-pipeline-components 2.22 (notification e-mail) | notification d'astreinte sans code |
Coût mesuré de make run : 38 appels Gemini, environ 19 000 tokens, moins d'un centime. Une exécution sur Vertex AI coûte 0,03 de l'heure pour une e2-standard-4 au tarif public), soit quelques centimes. Durée : 5 h de lecture et de pratique ; make run prend 3 min 17 s.
Prérequis
- Python courant, notions de prompts et d'évaluation de LLM.
- Pour
make run: une clé d'API Gemini, ougcloud auth application-default loginetGOOGLE_GENAI_USE_VERTEXAI=TRUE. - Pour
make e2e: un projet Google Cloud avec l'API Vertex AI activée et le quota ci-dessus. - Sans rien de tout cela :
make test(12 tests, sans réseau) et la compilation restent possibles.
Programme
| # | Leçon | Vous finissez avec |
|---|---|---|
| 1 | Un cycle LLM qu'on peut rejouer | make test vert et le pipeline compilé |
| 2 | Préparer le jeu et évaluer un prompt | deux composants testés avec un faux Gemini |
| 3 | La porte de promotion | make run qui promeut v2 sur votre poste |
| 4 | Cache, paramètres, planification | une clé de cache qui suit le contenu des données |
| 5 | Exécuter sur Vertex AI Pipelines | make cloud-up et make e2e, quota compris |
| 6 | Métadonnées, coûts, nettoyage | make cloud-down vérifié, rien ne subsiste |
Le dépôt complet est dans files/ ; commencez par son README.
Recursos
- example.env.example1 KB
- pycomponents.py10 KBVer
- pypipeline.py4 KBVer
- mdREADME.md2 KBVer
- txtrequirements.txt1 KBVer
- pyrun.py9 KBVer
Referencias
- Vertex AI Pipelines : introductioncloud.google.com
- Vertex AI Pipelines : construire un pipelinecloud.google.com
- Vertex AI Pipelines : configurer le cache d'exécutioncloud.google.com
- Vertex AI Pipelines : planifier une exécutioncloud.google.com
- Vertex AI Pipelines : types de machines d'une étapecloud.google.com
- Kubeflow Pipelines : exécuter un pipeline en localkubeflow.org
- Vertex AI Experiments : introductioncloud.google.com
- Vertex AI : tarifscloud.google.com