Curso

Assistant data conversationnel

Un agent Google ADK qui répond en français aux questions métier sur les ventes : couche sémantique en YAML, SQL paramétré validé par dry-run (≤ 1 Go, lecture seule, liste blanche), graphique Vega-Lite choisi par la forme du résultat, évaluation sur 20 questions et déploiement Cloud Run privé.

Experto 7 lecciones 10h
Empezar el curso
Progreso 0% · 0/7

Este contenido aún no está traducido. Se muestra la versión original.

Le directeur commercial pose une question simple au canal #data : « Quel rayon a le mieux progressé cette année ? ». Trois personnes répondent avec trois chiffres différents. L'une a compté les commandes annulées, l'autre a pris la date d'expédition, la troisième a filtré « Women » sur le genre du client au lieu du rayon du produit. Personne n'a tort en SQL. Tout le monde a tort en métier.

Brancher un LLM directement sur l'entrepôt reproduit ce problème à grande échelle, avec de l'aplomb en plus. Ce projet construit l'inverse : un assistant qui ne voit jamais le schéma physique. Il choisit des métriques et des axes dans une couche sémantique (un fichier YAML qui fixe les définitions métier et les jointures permises) ; un compilateur écrit le SQL ; quatre garde-fous le valident avant qu'un octet ne soit facturé.

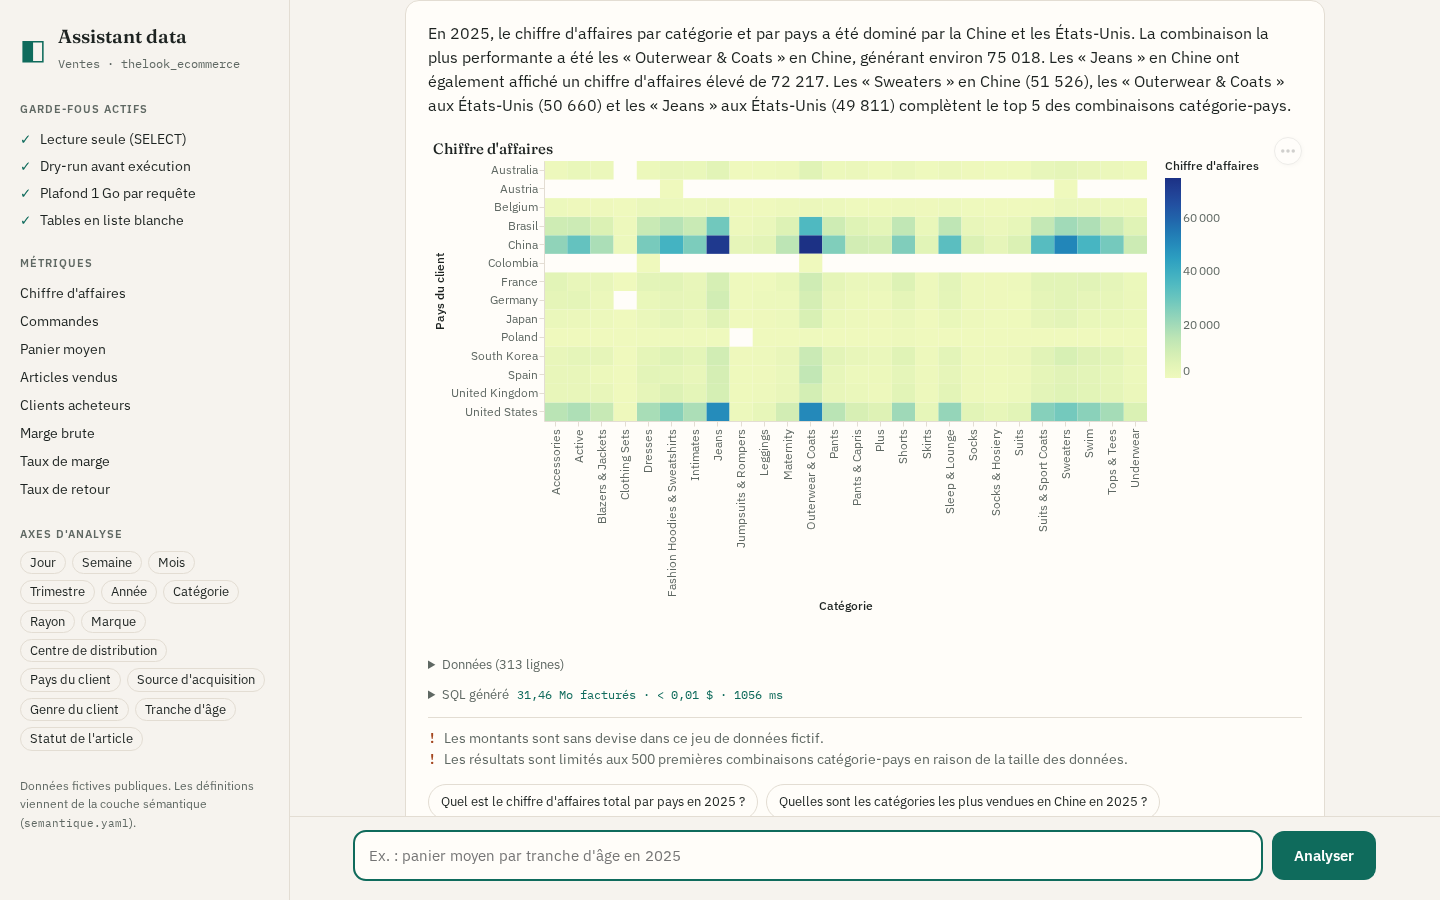
L'assistant déployé sur Cloud Run privé : chiffre d'affaires par catégorie et pays, carte de chaleur choisie par le code

Ce que vous livrez

LivrableDétail
Couche sémantiquesemantique.yaml : 8 métriques, 15 dimensions, 3 jointures, valeurs exactes des filtres
Agent ADKGemini 2.5 Flash sur Vertex AI, un seul outil interroger, sortie structurée (réponse, limites, 3 questions de suite)
Garde-fouscontrôle statique, dry-run, liste blanche de tables, plafond de 1 Go, paramètres BigQuery, plafond d'appels modèle
Interface webconversation, graphiques Vega-Lite interactifs, tableau des données, SQL dépliable avec octets facturés, coût et durée
Évaluation20 questions de référence, résultats attendus recalculés à chaque passage par du SQL écrit à la main
DéploiementCloud Run privé, compte de service à deux rôles, dépôt d'images dédié, nettoyage vérifié
Kit LinkedInfiles/linkedin/ : post, carrousel de 5 visuels 1080×1350, vidéo de démonstration

Architecture

flowchart LR
  U["Question en français"] --> W["API FastAPI + interface web"]
  W --> A["Agent ADK (Gemini 2.5 Flash, Vertex AI)"]
  A -->|"interroger(métriques, dimensions, filtres, période)"| C["Compilateur sémantique"]
  Y["semantique.yaml"] --> C
  C -->|"SQL + paramètres"| G{"Garde-fous"}
  G -->|"1. statique"| G
  G -->|"2. dry-run"| BQ[("BigQuery thelook_ecommerce")]
  G -->|"3. tables, 1 Go"| E["Exécution maximum_bytes_billed"]
  E --> BQ
  E --> V["Choix du graphique + spec Vega-Lite"]
  V --> A
  A -->|"réponse, limites, suites"| W

Le modèle propose ; le code dispose. Le modèle choisit des noms dans un catalogue fermé, jamais du SQL. Le code écrit la requête, la vérifie, l'exécute, choisit le graphique d'après la forme du résultat. Cette séparation rend chaque étape testable sans modèle : 57 tests tournent en 2 secondes sans identifiants.

Stack et coûts mesurés

ComposantChoixCoût mesuré le 2026-10-15
Modèlegemini-2.5-flash, Vertex AI europe-west12 à 3 appels par question
DonnéesBigQuery, jeu public thelook_ecommerce (US)10,5 à 31,5 Mo facturés par requête (minimum 10 Mo par table)
Évaluation complète20 questions336 Mo facturés, soit 0,002 $ de BigQuery (20/20 exacts, 2026-10-16)
ServiceCloud Run, --max-instances 1, sans instance minimalequelques centimes pour un test d'une heure

Au tarif à la demande (6,25 $ par Tio, premier Tio mensuel gratuit), une question coûte moins d'un dixième de centime de BigQuery. Le poste de coût réel est le modèle ; il reste de l'ordre du centime par question avec Flash.

Prérequis

  • Python 3.10+, gcloud authentifié (gcloud auth application-default login), Docker pour le déploiement.
  • Un projet Google Cloud avec BigQuery et Vertex AI activés, et le droit de créer un compte de service.
  • À l'aise avec SQL (agrégats, jointures) et les bases d'ADK : agent, outil, runner. Le lab Analyste BigQuery avec ADK est un bon point de départ.

Programme

ModuleLeçonVous finissez avec
1. CadrerLe problème et l'architecturemake setup et make test verts
2. Couche sémantiqueModéliser les métriques en YAMLle SQL compilé d'une question, sans modèle
Les quatre garde-fous SQLun dry-run réel et un refus mesuré
3. Agent et interfaceL'agent ADK et sa sortie structuréeune question réelle en ligne de commande
Graphiques et interface webmake run et l'interface complète
4. Évaluer et déployerÉvaluer sur 20 questionsmake e2e : 20/20
Déployer sur Cloud Run privémake cloud-up, test authentifié, make cloud-down vérifié

Le dépôt complet est dans files/ : il se clone et tourne tel quel.

Kit de publicación para LinkedIn

La publicación, el carrusel y el vídeo de demo, listos para publicar cuando termines el proyecto.

La publicación

Post LinkedIn

À publier avec les 5 images carrousel-1.png à carrousel-5.png (format document ou images), ou avec demo.mp4 (30 s, sans son). Les visuels se régénèrent avec node linkedin/capturer.mjs.


J'ai construit un assistant data conversationnel avec Google ADK, et la décision qui a tout changé tient en une phrase : le modèle ne voit jamais le schéma.

On pose une question en français sur les ventes d'une boutique en ligne (jeu public BigQuery thelook_ecommerce). L'agent choisit des métriques, des axes et des filtres dans une couche sémantique en YAML. Le code écrit le SQL, le valide (lecture seule, dry-run, tables en liste blanche, plafond de 1 Go appliqué par BigQuery), l'exécute, choisit le graphique d'après la forme du résultat et le rend en Vega-Lite. Le modèle explique, cite les limites et propose trois questions de suite.

Mesuré les 15 et 16 octobre 2026, sur 20 questions de référence dont les résultats sont recalculés par du SQL écrit à la main, sans la couche sémantique :

  • 20 résultats exacts sur 20, comparés valeur par valeur ;
  • 18 graphiques du type attendu sur 18 ;
  • 2 refus corrects sur 2 (e-mails de clients, donnée absente du catalogue) ;
  • 336 Mo facturés pour toute l'évaluation, soit 0,002 $ de BigQuery.

Trois choses apprises en le cassant :

  1. Sommer sale_price sur tous les statuts gonfle le chiffre d'affaires 2025 de 34 %. Le SQL est valide, la réponse est fluide, le chiffre est faux. La définition vit dans le YAML, une seule fois, et la réponse la cite.

  2. Un paramètre d'outil en objets imbriqués a produit 185 appels à des outils qui n'existent pas. Des paramètres plats, validés par le code, et un plafond de 8 appels modèle par question ont réglé le problème.

  3. Laisser le modèle choisir le graphique donne des courbes entre catégories. La forme du résultat décide ; la suggestion n'est retenue que si elle est compatible.

Déployé sur Cloud Run privé (compte de service à deux rôles, 403 sans jeton), testé, puis supprimé avec une vérification qui échoue s'il reste une ressource.

Vingt questions valident la chaîne, pas un taux de réussite en production : le jeu grandit avec chaque question réelle mal traitée.

Le code, les 57 tests sans identifiants et le tutoriel pas à pas sont en accès libre dans la formation.

#GoogleADK #BigQuery #Gemini #DataEngineering #IA

post.md

Recursos

Descargar todo (.zip)

Referencias