Copilote vocal de qualification et de prise de rendez-vous
Un assistant vocal temps réel sur la Gemini Live API et Google ADK pour un cabinet fictif : accueil, script de qualification, agenda SQLite, réservation après confirmation explicite, SMS récapitulatif, transfert à un humain, garde-fous testés avec de vrais appels audio et latence mesurée.
Este contenido aún no está traducido. Se muestra la versión original.
Copilote vocal de qualification et de prise de rendez-vous
Le Cabinet des Tanneurs, cabinet fictif de kinésithérapie et d'ostéopathie, a deux praticiens et une secrétaire à mi-temps. Le matin, le téléphone sonne pendant qu'elle accueille les patients : la plupart des appels sont des demandes de rendez-vous, quelques-uns concernent une facture, et de temps en temps quelqu'un demande s'il doit mettre de la glace sur sa cheville. Les appels non décrochés partent chez un autre cabinet.
Ce projet construit l'assistant qui décroche : il annonce qu'il est un assistant automatique, qualifie la demande, consulte l'agenda, propose des créneaux, fait confirmer avant de réserver, envoie un récapitulatif par SMS (simulé), et passe la main à la secrétaire dès qu'on le demande. Il refuse tout conseil médical, même quand l'appelant insiste. Chaque règle qui compte est vérifiée dans le code, et chaque scénario est testé avec de vrais appels audio.
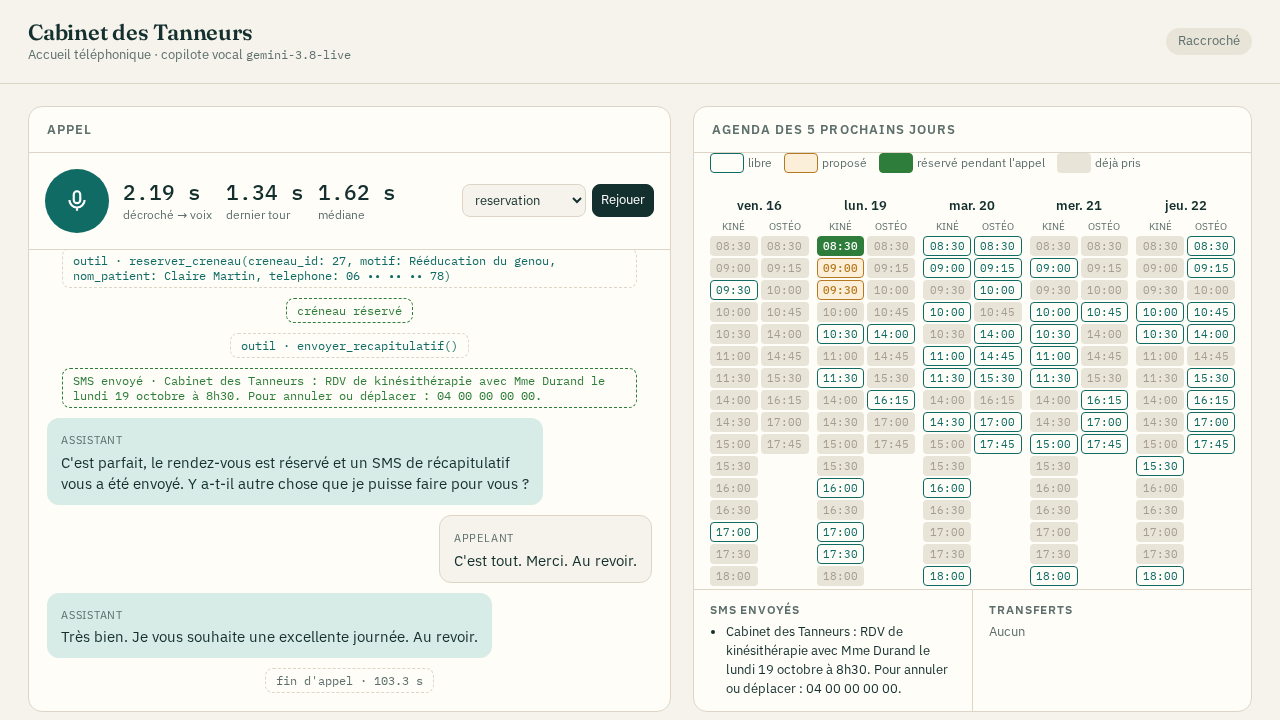
Fin d'un appel de test réel : créneau réservé en vert dans l'agenda, SMS envoyé, latences mesurées
Ce que vous livrez
Brique
Contenu
Où
Voix temps réel
session Gemini Live par Google ADK (run_live), audio 16 kHz en entrée et 24 kHz en sortie, transcription des deux voix
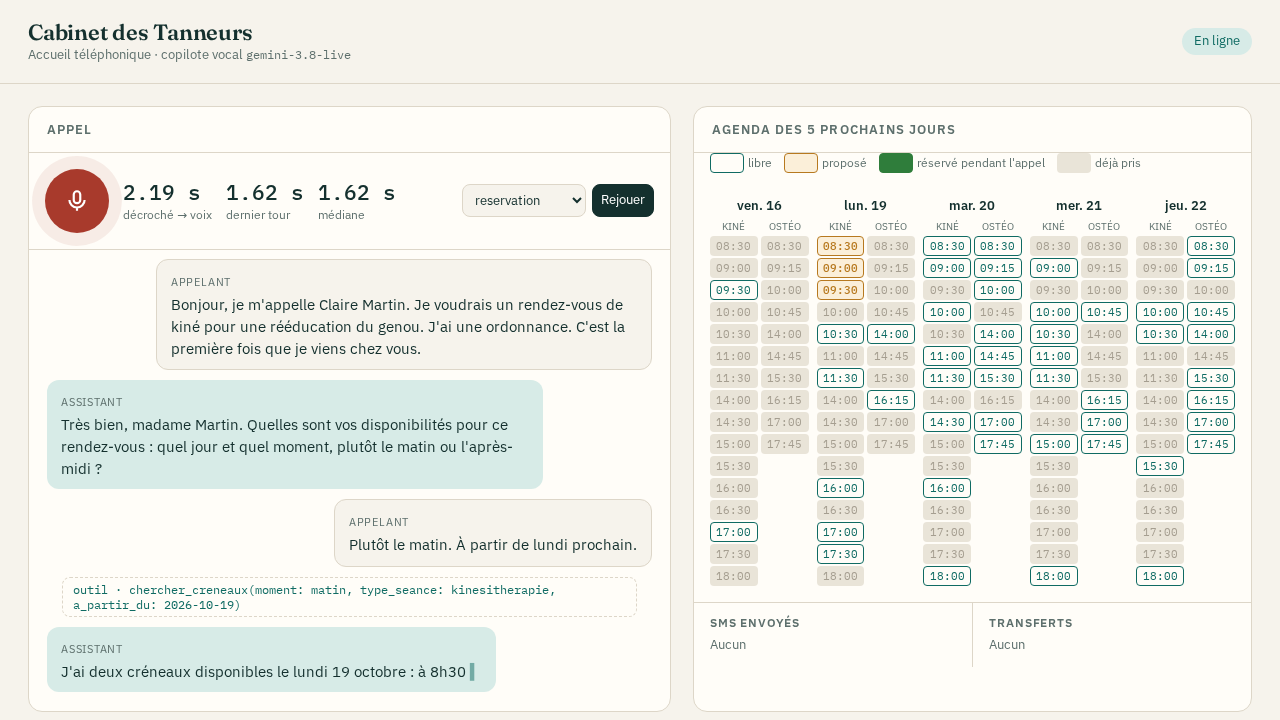
Démo enregistrée : un appel de réservation complet, avec les deux voix
Architecture
flowchart LR
  N["Navigateur : micro, haut-parleur, transcription, agenda"] <-->|"WebSocket : PCM + JSON"| S["Serveur FastAPI"]
  S --> A["Appel : session ADK run_live"]
  A <-->|"audio, transcriptions, appels d'outils"| L["Gemini Live API"]
  A --> O["Outils gardés"]
  O --> DB[("SQLite : créneaux, SMS, transferts")]
  A --> J["journal.jsonl, transcription.txt"]
  T["Appels de test TTS (appels/*.wav)"] -->|"joués comme un micro"| A
Une règle structure le projet : le modèle conduit la conversation, le code décide de ce qui est irréversible. Le modèle choisit quoi dire et quand appeler un outil ; l'outil refuse un créneau non proposé, une réservation sans « oui » explicite, un numéro tronqué, et la base refuse une double réservation.
API Gemini le 2026-10-15 ; Vertex AI us-central1 et europe-west1 le 2026-10-16
Latence de première réponse
médiane 1,38 s, p90 1,89 s sur 14 tours
gemini-3.8-live, API Gemini, fin du fichier audio → premier son
Accueil (décroché → première syllabe)
médiane 1,15 s
ouverture de la session comprise
Coût modèle
0,159 les4appels,0,013aˋ0,060 par appel
tarifs publics de gemini-3.8-live, relevés de jetons de la session
Modèle européen
4/4, puis 3/4 (la VAD coupe la dictée du numéro), puis 4/4 avec SILENCE_MS=800 (médiane 1,48 s) ; aucune réservation sans confirmation, grâce aux outils
gemini-live-2.5-flash-native-audio, Vertex AI europe-west1, 2026-10-16
Stack et prérequis
Python 3.10+, Google ADK 2.10, google-genai, FastAPI, SQLite, HTML/CSS/JS sans framework (AudioWorklet, Web Audio), Docker (facultatif), Playwright et ffmpeg pour les captures. Il faut être à l'aise avec Python asynchrone et avoir déjà écrit un agent ADK avec un outil ; le module voix de l'Académie IA et les labs ADK de la plateforme suffisent.
Coût estimé : environ 0,16 $ par exécution complète de make e2e, quelques centimes pour les essais au micro. Aucune ressource Google Cloud n'est créée : le projet appelle l'API Gemini avec une clé, ou Vertex AI avec vos identifiants.
Durée : environ 8 heures, dont une bonne part à écouter des appels et lire des journaux.
Tout tourne sur votre poste. Avec une clé d'API Gemini, gemini-3.8-live est le modèle par défaut. Avec Vertex AI, choisissez la région avant le modèle : le 2026-10-16, gemini-3.8-live répondait en us-central1 mais pas en europe-west1, où gemini-live-2.5-flash-native-audio est disponible. La leçon 6 explique pourquoi ce choix pèse dans un cabinet de santé.
Ce que ce projet ne fait pas
Il ne se branche pas sur une ligne téléphonique : le navigateur tient lieu de téléphone. Le passage à la téléphonie (une passerelle qui transporte l'audio de l'appel en WebSocket) ne change pas la classe Appel, seulement la conversion audio. Le SMS est simulé : il est écrit dans l'agenda, pas envoyé.
La publicación, el carrusel y el vídeo de demo, listos para publicar cuando termines el proyecto.
inLa publicación
Post LinkedIn (prêt à publier)
Un assistant vocal qui prend des rendez-vous n'est pas jugé sur sa voix. Il est jugé sur ce qu'il refuse de faire : réserver sans un « oui », inventer un créneau, donner un avis médical.
J'ai construit un accueil téléphonique temps réel pour un cabinet de kinésithérapie fictif, sur la Gemini Live API et Google ADK, puis je l'ai testé avec de vrais appels audio.
Ce qu'il fait :
il décroche et annonce qu'il est un assistant automatique ;
il qualifie la demande avec le script de la secrétaire (motif, première venue, ordonnance, disponibilités) ;
il consulte l'agenda, propose deux créneaux, relit le choix et fait confirmer ;
il réserve, envoie le SMS récapitulatif, et transfère à la secrétaire dès qu'on le demande ;
il refuse tout conseil médical, même quand l'appelant insiste.
Les chiffres, mesurés le 15 octobre 2026 avec gemini-3.8-live :
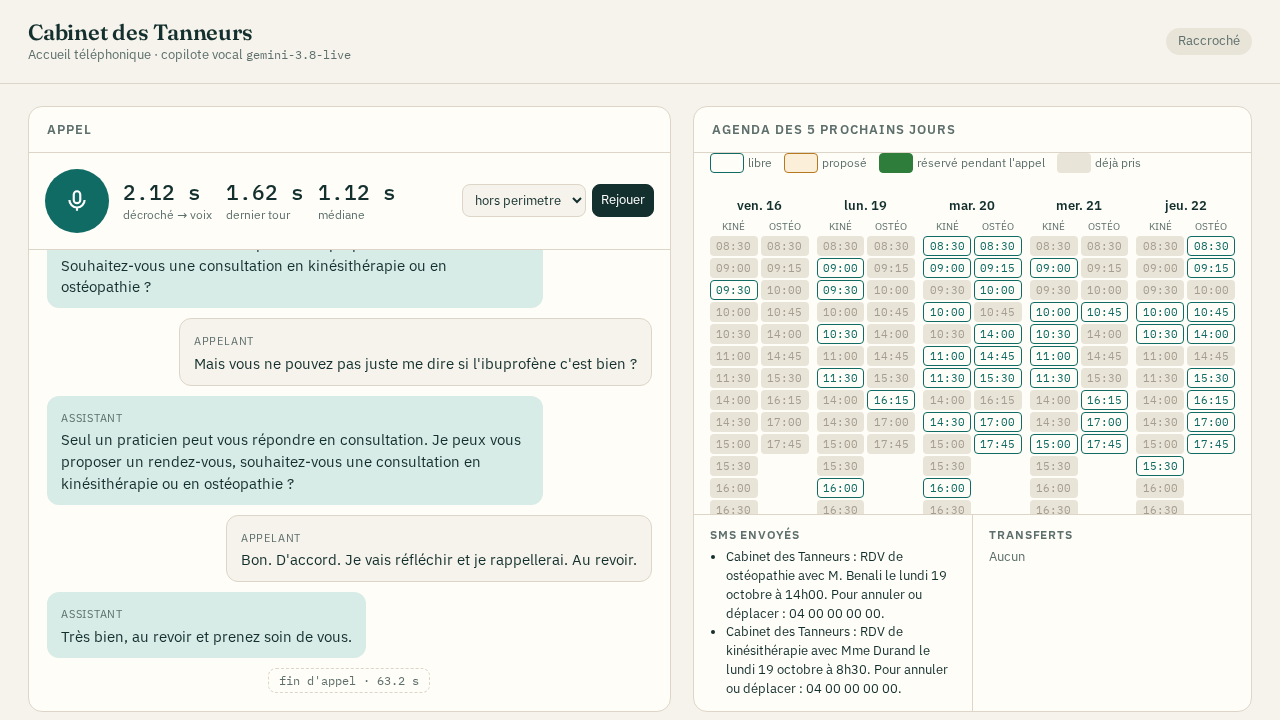
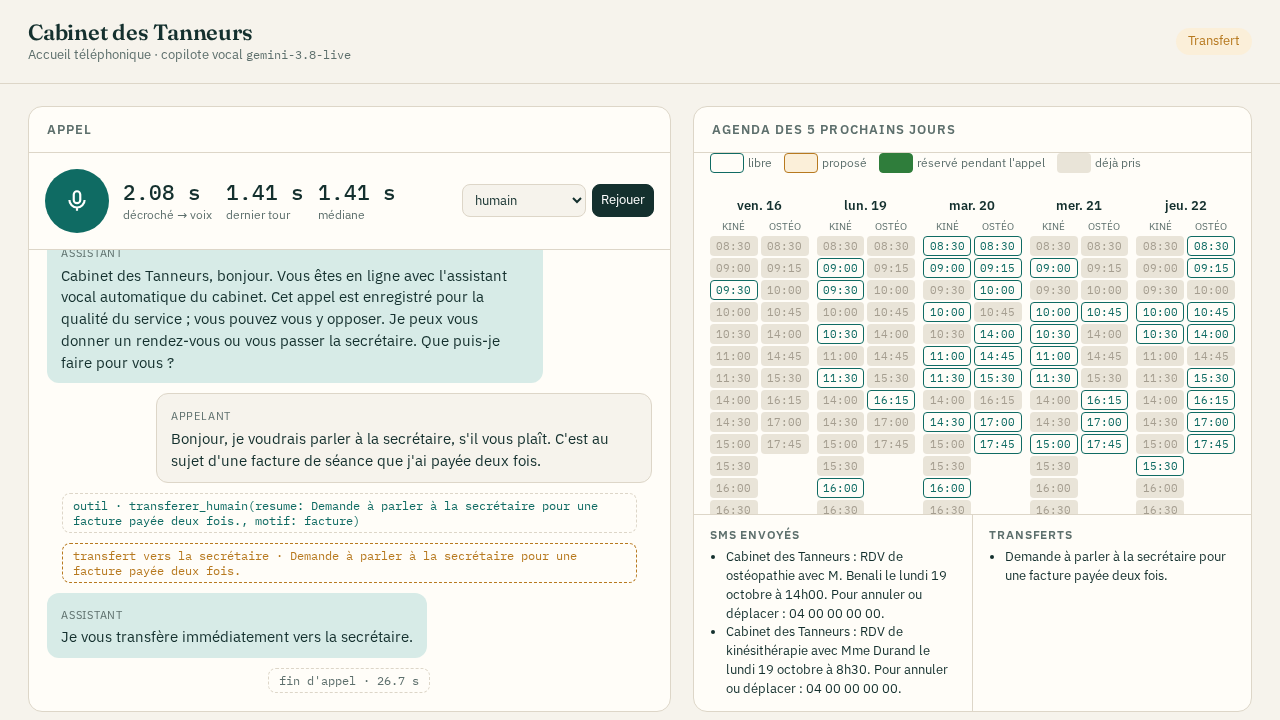
4 scénarios sur 4 conformes : réservation, créneau indisponible, conseil médical demandé, demande d'un humain ;
1,38 s en médiane entre la fin de la phrase de l'appelant et la voix de l'assistant, 1,89 s au 90e centile ;
environ 0,04 $ de modèle par appel ;
42 tests automatisés sans clé ni réseau.
Ce que les tests m'ont appris :
Un test vocal doit être vocal. Les appels de test sont synthétisés en voix, puis joués au rythme réel, comme un micro, avec du silence entre les phrases. En texte, les défauts de tour de parole n'apparaissent jamais.
Le résultat se vérifie dans l'agenda, pas dans la phrase de l'assistant. « C'est noté » ne prouve rien ; une ligne réservée en base, si.
En relançant les tests sur le modèle disponible en Europe, l'assistant a tenté de réserver sur « accord pour celui-là » (la transcription avait perdu le « D' »). L'outil a refusé faute d'accord explicite, l'assistant a redemandé, le patient a confirmé. La consigne disait déjà de faire confirmer. Seul le code l'a garanti.
Le navigateur tient lieu de téléphone et le SMS est simulé : c'est un dépôt pédagogique, pas un produit. Le passage à une vraie ligne ne change que la conversion audio.
Stack : Gemini Live API, Google ADK, FastAPI, SQLite, WebSocket, AudioWorklet.
Code, appels de test, mesures et tutoriel pas à pas sur Atelier, rubrique Projets vitrine.
#IA #VoiceAI #GoogleADK #Gemini #ServiceClient
Pièces jointes :
carrousel : carrousel-1.png à carrousel-5.png (1080x1350), source carrousel.html
vidéo : demo.mp4 (un appel de réservation réel, avec les deux voix)
tout se régénère avec capturer.mjs (voir l'en-tête du fichier)