Pourquoi l'infographie ne se génère pas d'un bloc
Une infographie publiée avec un chiffre faux coûte plus cher qu'une infographie en retard : rectificatif, perte de crédibilité, parfois un problème réglementaire quand il s'agit d'un bilan carbone ou financier. Or les modèles d'image savent désormais écrire du texte lisible. La question n'est donc plus « est-ce joli ? » mais « est-ce que je peux le prouver juste, le corriger et le décliner sans tout refaire ? ».
L'expérience du 2026-10-15
Le même prompt, avec le CSV collé tel quel, envoyé à deux modèles. Vous pouvez le rejouer : python -m infographie.naif gemini-3.1-flash-image (une image, environ 0,07 $).
Crée une infographie professionnelle en français, format portrait, pour le bilan énergétique 2026
de Rivage Logistique, à partir de ces données CSV. Titre, consommation totale 2025 et 2026,
variation en pourcentage, un graphique en barres par site avec les valeurs, la part solaire de chaque site.
site,ville,conso_2025_mwh,conso_2026_mwh,part_solaire_pct
Entrepôt Nord,Lille,1840,1512,22
...
gemini-3.1-flash-image | gemini-3-pro-image |
|---|---|
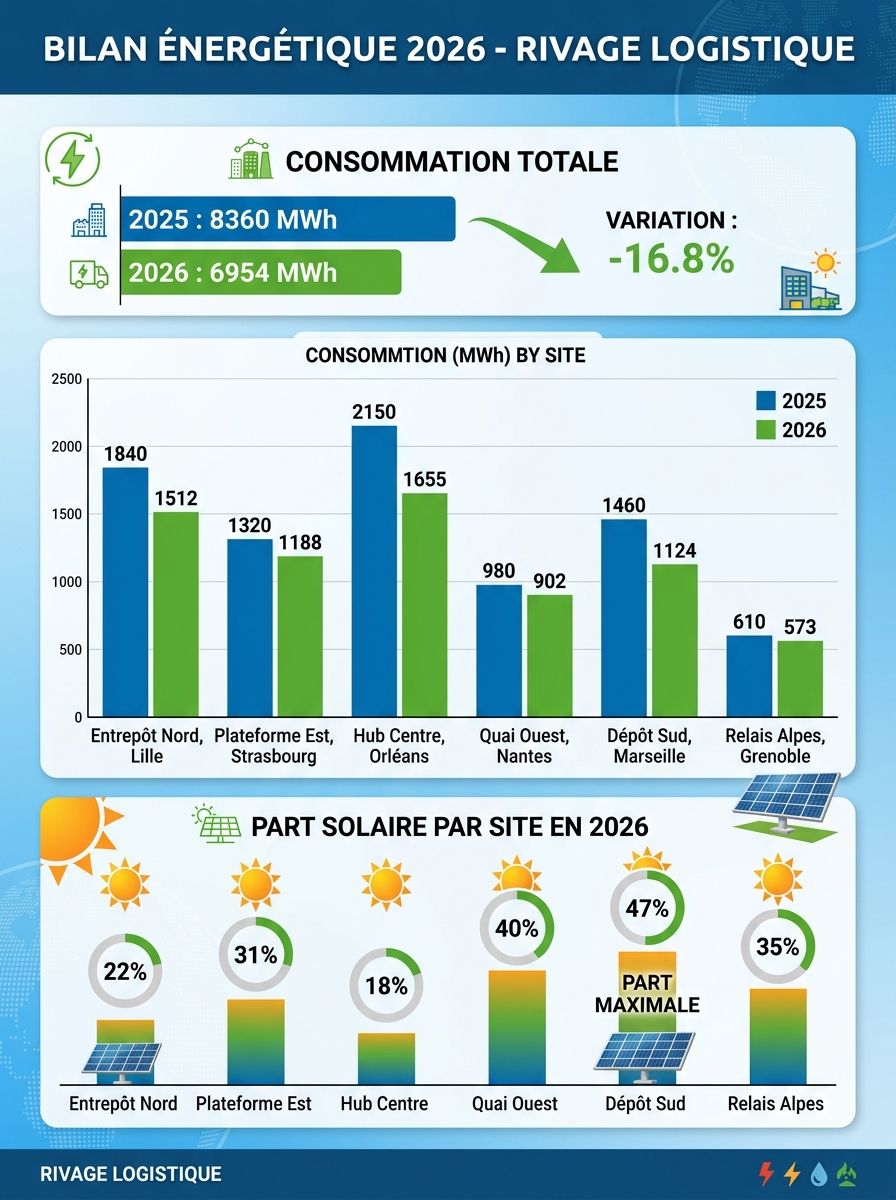 | 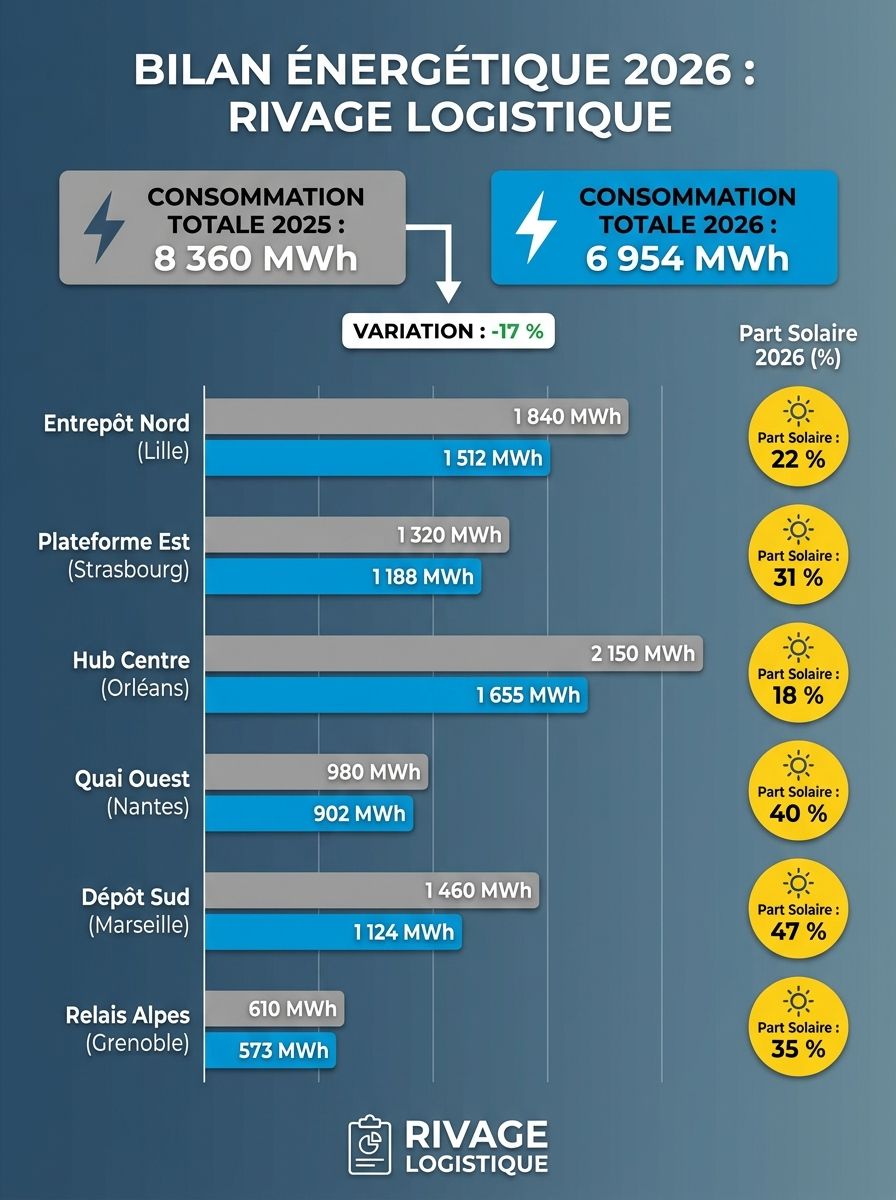 |
Relecture ligne à ligne :
| Défaut constaté | Flash Image | Pro Image |
|---|---|---|
| Coquille ou langue mélangée | « CONSOMMTION (MWh) BY SITE » | aucune sur ce tirage |
| Format des nombres | « -16.8% », « 8360 MWh » (anglais) | « 8 360 MWh » correct, mais « -17 % » arrondi sans consigne |
| Totaux 8 360 et 6 954 | justes | justes |
| Échelle des barres | axe présent ; jauges solaires sans échelle, badge « PART MAXIMALE » qui recouvre une barre | aucun axe : impossible de vérifier les longueurs |
| Correction d'un seul chiffre | régénérer toute l'image | régénérer toute l'image |
Le modèle Pro a eu raison sur ce tirage. Cela ne change pas la décision : vous ne pouvez pas le prouver sans relire chaque pixel, et le prochain tirage, ou le format story, sera une autre image avec d'autres risques. Quatre formats égalent quatre générations indépendantes, donc quatre relectures intégrales.
Votre directrice de la communication montre le rendu Pro ci-dessus : « Tous les chiffres sont justes, pourquoi ne pas l'utiliser directement ? » Quel argument tranche ?
L'argument porte sur la vérifiabilité et la maintenance, pas sur l'erreur observée. « Toujours des fautes » est faux ici (ce tirage est juste) et ne convaincra personne. Le coût d'une image (0,13 $) est négligeable face à une relecture humaine. Le français est bien rendu par le modèle Pro.
Le partage des rôles
La méthode tient en une règle : ce qui porte une information vérifiable sort du code ; ce qui porte une ambiance sort du modèle.
flowchart TB
  subgraph CODE["Le code (déterministe, testé)"]
    A["Chiffres calculés depuis le CSV"]
    B["Texte final, format français"]
    C["Grille, typographie, couleurs"]
    D["Graphique de données"]
  end
  subgraph IA["Les modèles (créatifs, contrôlés)"]
    E["Gemini texte : angle, titres avec variables"]
    F["Gemini image : fonds, illustration, icônes"]
  end
  E -->|"gabarits validés"| B
  F -->|"détourés, mis en cache"| G["Composition en calques"]
  A --> G
  B --> G
  C --> G
  D --> G
  G --> H["Contrôle automatique"] --> I["PNG, SVG, PDF x 4 formats"]
| Élément | Qui le produit | Pourquoi |
|---|---|---|
| Chiffres, unités, pourcentages | code | doit être exact et testable |
| Titre, sous-titre | modèle texte, avec des variables {variation} remplies par le code | le modèle trouve l'angle, il n'écrit aucun chiffre |
| Graphique | code | la longueur d'une barre est une donnée |
| Fond, illustration, icônes | modèle d'image | aucune information, seulement du style |
| Mise en page | code | reproductible sur 4 formats |
| Contrôle | code | une machine relit tout, à chaque export |
Installer le projet
cd files
make setup     # .venv, dépendances, .env copié depuis .env.example
make test      # sans clé ni réseau
L'arborescence du dépôt :
files/
  Makefile  README.md  requirements.txt  .env.example  pytest.ini
  donnees/energie_entrepots_2026.csv
  polices/Inter-Regular.ttf  Inter-Bold.ttf  OFL.txt
  src/infographie/  config.py donnees.py structure.py visuels.py
                    scene.py mise_en_page.py controles.py export.py __main__.py naif.py
  tests/  ci/github-actions.yml
La police est livrée avec le code (Inter, licence SIL OFL). Ce n'est pas un détail : le contrôle de débordement mesure le texte avec cette police précise. Une police système différente sur le poste d'un collègue donnerait d'autres largeurs.
Ce qui casse en production
| Symptôme | Cause | Parade |
|---|---|---|
| Un chiffre faux publié dans une image générée | le modèle a recopié ou arrondi de lui-même | aucun chiffre dans un prompt d'image ; le texte est posé par le code |
| La story dit « −17 % », l'affiche « −16,8 % » | deux générations indépendantes | une seule source de faits, recomposée par format |
| Le juridique demande de corriger un libellé la veille de la publication | le texte est figé dans les pixels | texte dans un calque à part, régénéré en secondes |
| Un lecteur d'écran ne lit rien | infographie = une image sans texte alternatif | texte alternatif produit avec les mêmes faits, SVG et PDF à texte réel |
Règle de décision
- Générer d'un bloc : maquette d'intention pour un brief, moodboard, visuel sans aucune donnée. Jamais pour publication.
- Composer en calques : dès qu'un chiffre, un nom propre ou une mention légale apparaît, ou dès qu'il faut plus d'un format.
- À surveiller : la tentation de « juste corriger le chiffre » dans l'image générée par retouche. C'est une infographie dont plus personne ne connaît la source.
Un chef de produit veut une affiche pour un salon, sans aucun chiffre : un slogan de 5 mots et une illustration. Quelle approche retenez-vous ?
Sans données, le risque principal n'est plus le chiffre faux mais le texte mal rendu ou impossible à corriger. Poser le slogan à part coûte peu et le garde modifiable. Le pipeline complet est surdimensionné pour une affiche sans données ; la génération d'un bloc fige le slogan dans les pixels.
Exercice
Rejouez l'expérience avec python -m infographie.naif (une image), puis listez au moins trois vérifications qu'un relecteur humain devrait faire sur le résultat pour le publier. Pour chacune, indiquez quel module du projet la rend inutile.
Voir la solution
| Vérification humaine | Rendue inutile par |
|---|---|
| Chaque chiffre correspond au CSV | donnees.py : les faits sont calculés et testés (test_faits_calcules) |
| Format français (espace insécable, virgule, signe moins) | fr_nombre et fr_pct, testés |
| Longueur des barres proportionnelle aux valeurs | graphique() calcule chaque longueur depuis la donnée |
| Aucune coquille, aucune langue mélangée | le texte n'est jamais dessiné par le modèle |
| Texte lisible sur le fond | controles.py mesure le contraste sur les pixels |
| Les quatre formats disent la même chose | une seule Structure et un seul Faits pour tous les formats |
Résultat obtenu
Exécuté le 2026-10-15 sur le dépôt de files/ :
$ make test
.......................                                                  [100%]
23 passed in 6.49s
Je sais faire
- Expliquer pourquoi un rendu juste n'est pas une preuve de justesse
- Répartir chaque élément d'une infographie entre code et modèle
- Installer le projet et lancer les tests sans clé