Formation

Agent de support omnicanal en production

Construire, mesurer et déployer un agent ADK de service client : widget web et WhatsApp, RAG sur FAQ et CGV, outils commande, suivi et retour, escalade vers un conseiller avec reprise, tableau de bord temps réel, évaluation sur 30 conversations, Cloud Run.

Avancé 8 leçons 8h
Commencer la formation
Progression 0% · 0/8

Agent de support omnicanal en production

Lin & Lumière, boutique en ligne fictive de linge de maison basée à Nantes, traite environ 1 200 commandes par mois avec deux conseillères, du lundi au samedi midi. Les mêmes questions reviennent sur le site et sur WhatsApp : frais de port, « où est mon colis », « je veux renvoyer la housse ». Le soir et le week-end, personne ne répond. La direction veut un assistant qui traite seul les demandes simples, qui transmet le reste à une conseillère sans perdre le fil, et dont on connaît le coût et la qualité avant de l'ouvrir aux clients.

Ce projet construit cet assistant de bout en bout, le mesure, le déploie sur Cloud Run, puis supprime tout.

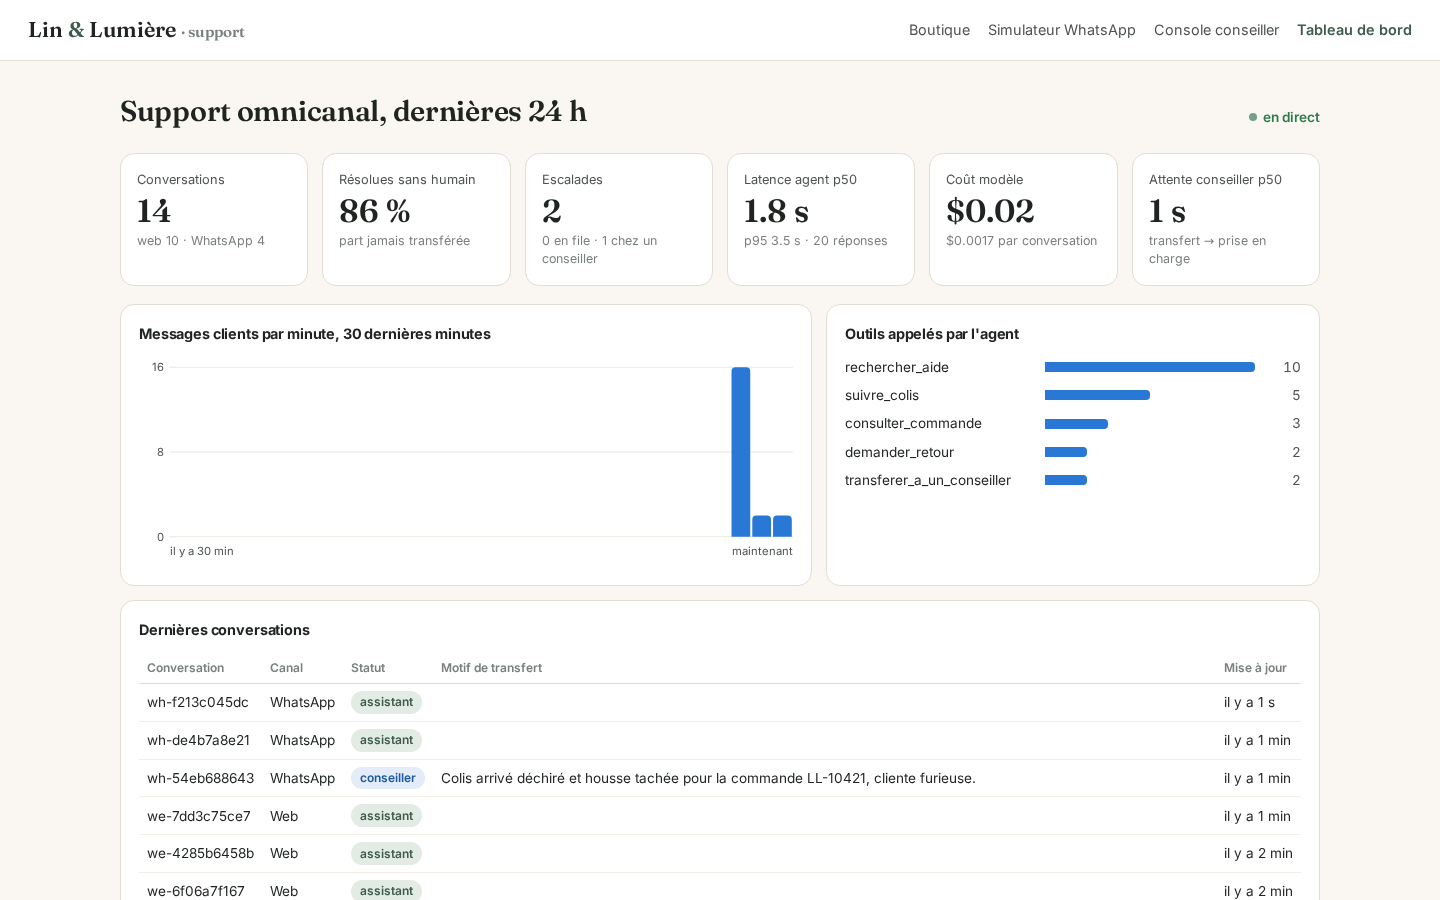
Tableau de bord du support, rempli par de vraies conversations (2026-10-15)

Ce que vous livrez

BriqueContenuOù
AgentGoogle ADK, 5 outils, consignes de sécuritésupport/agent.py, support/tools.py
RAG29 passages (FAQ + CGV), gemini-embedding-2, repli BM25 sans clésupport/kb.py
Canauxwidget web ; webhook WhatsApp signé et simulateur au format Metasupport/app.py, support/whatsapp.py
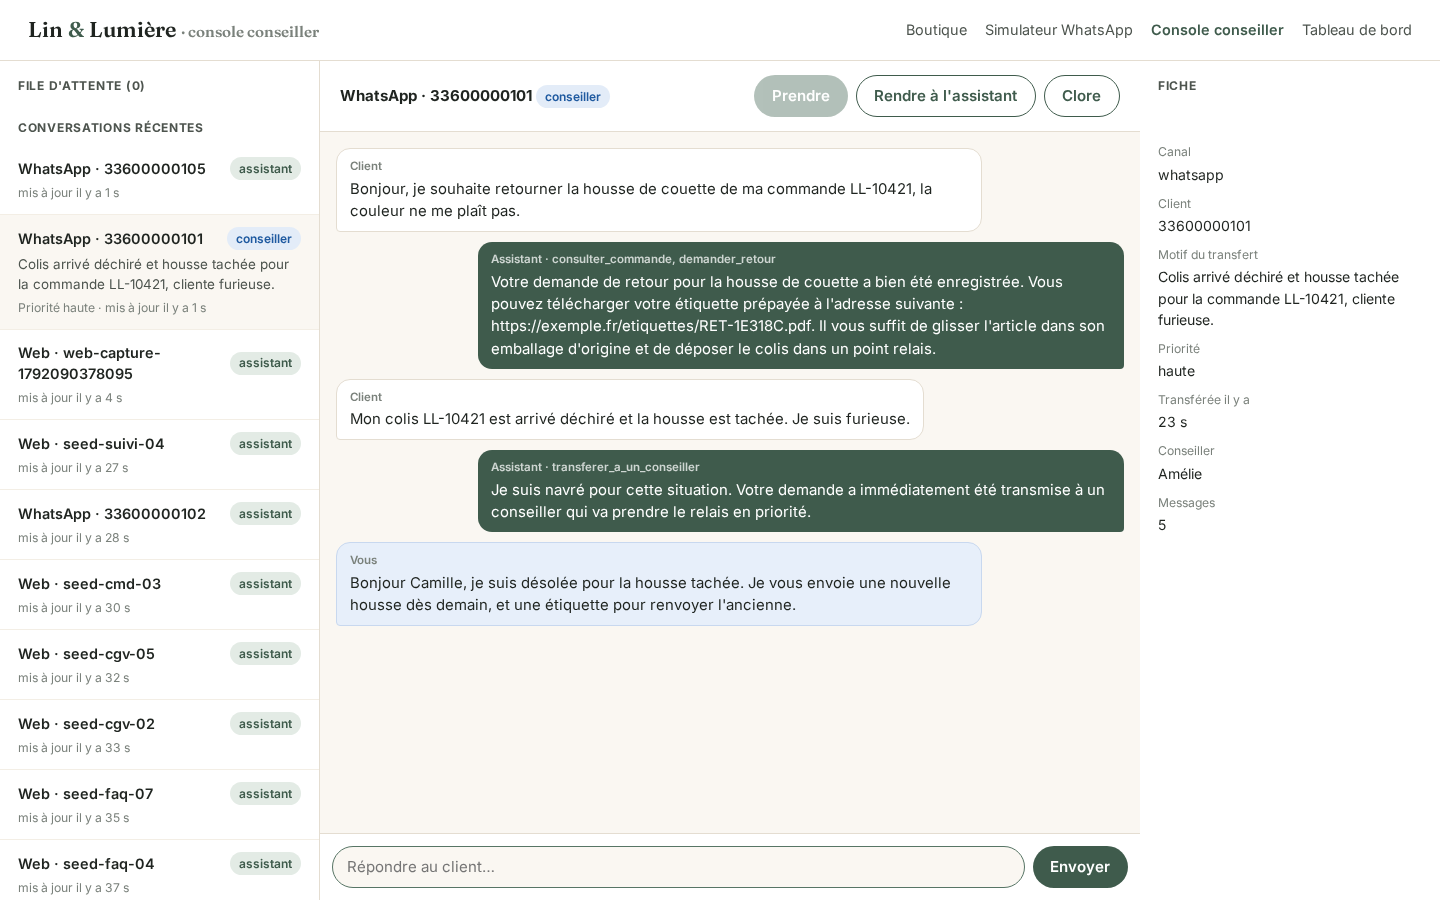
Escaladefile par priorité, console conseiller, reprise par l'agentsupport/service.py, web/conseiller.html
Pilotagetableau de bord temps réel (SSE) : conversations, résolution, escalades, latence, coûtsupport/metrics.py
Qualité18 tests sans clé, 30 conversations de référence avec seuil bloquanttests/, eval/
DéploiementDockerfile, make cloud-up / make cloud-down, CIMakefile
Publicationpost, carrousel de 5 visuels, vidéo de 22 slinkedin/
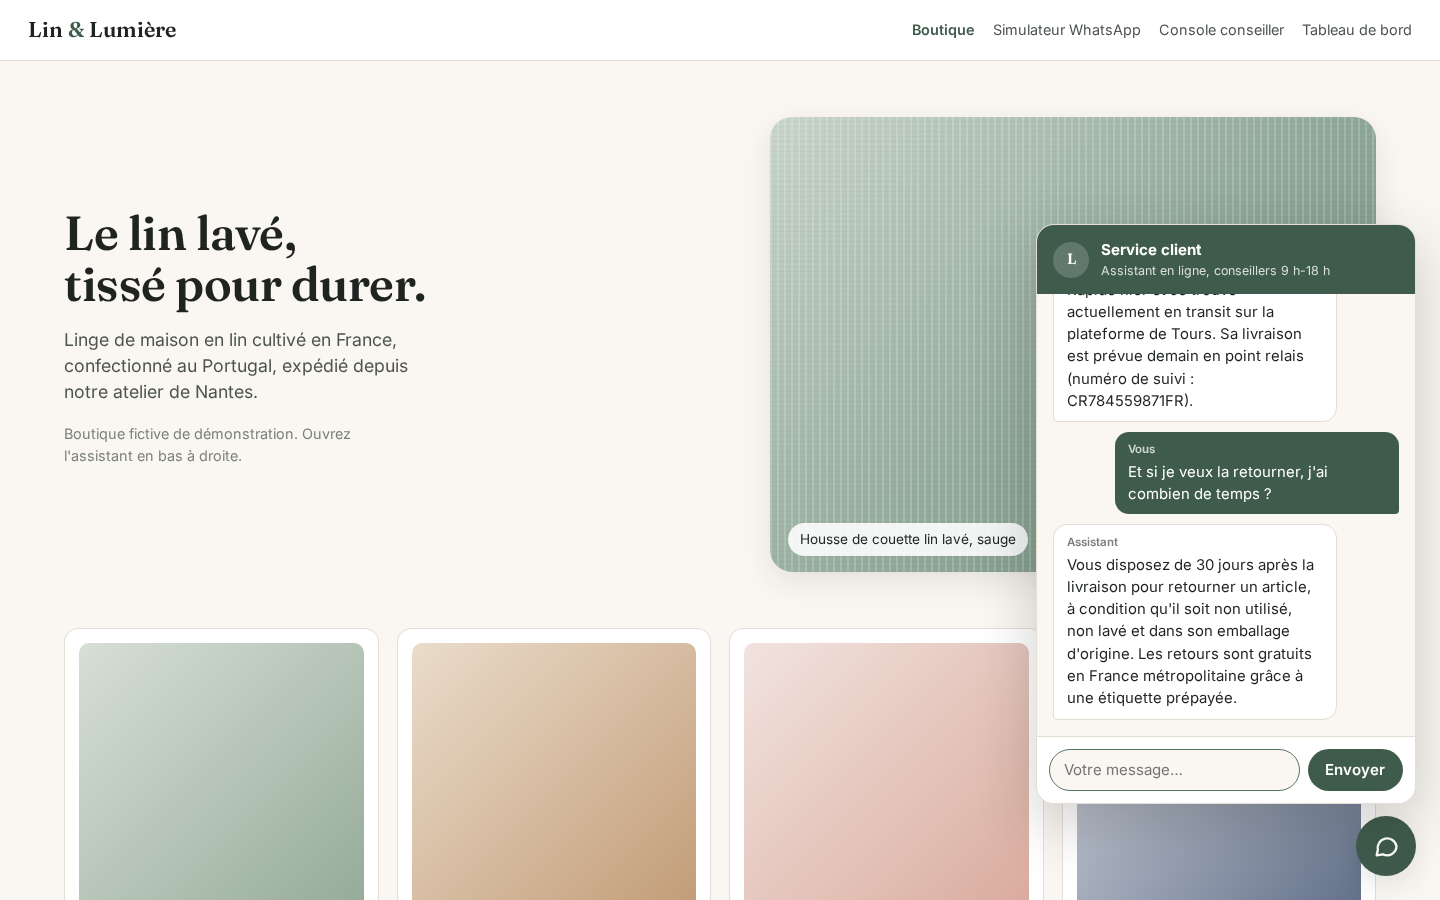
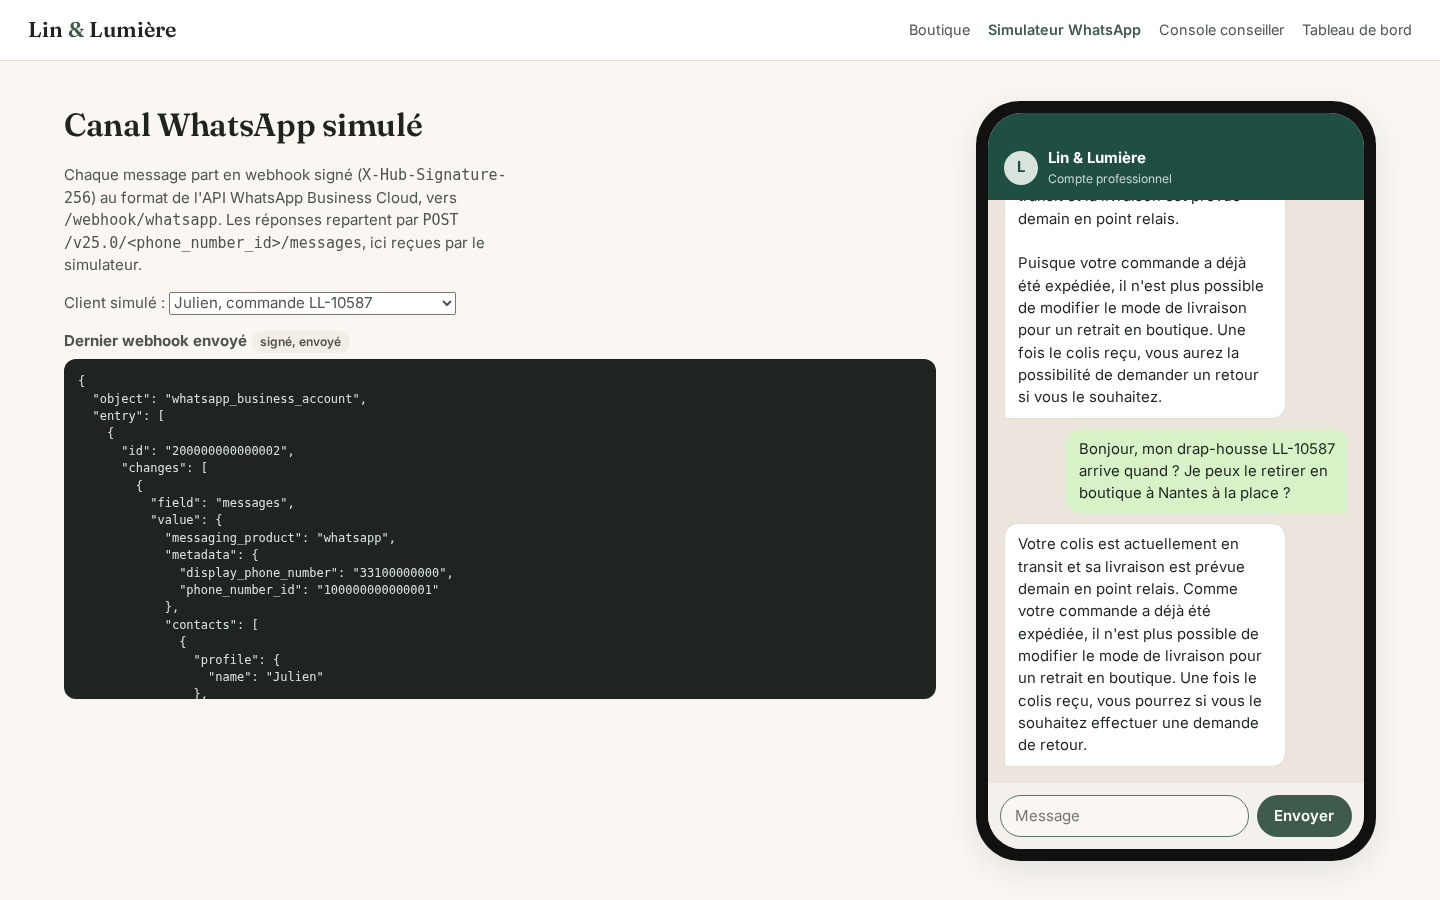
Widget webSimulateur WhatsAppConsole conseiller
Démo enregistrée : widget, WhatsApp, escalade, conseiller, tableau de bord

Architecture

flowchart LR
  W["Widget web"] -->|"POST /api/chat"| S
  M["Meta / simulateur"] -->|"webhook signé HMAC"| S
  S["SupportService : route selon le statut"] -->|"statut agent"| A["Agent ADK"]
  S -->|"en_attente / humain"| Q["File + console conseiller"]
  A --> T1["rechercher_aide (RAG)"]
  A --> T2["consulter_commande / suivre_colis"]
  A --> T3["demander_retour"]
  A --> T4["transferer_a_un_conseiller"]
  T4 --> Q
  Q -->|"rendre la main : contexte injecté"| A
  S --> DB[("SQLite : conversations, coûts, latences")]
  DB --> D["Tableau de bord (SSE)"]

Une seule règle structure tout le reste : le statut de la conversation vit en base, pas dans la mémoire de l'agent. C'est lui qui décide si un message part chez l'agent ou chez une conseillère, sur les deux canaux.

Résultats mesurés (2026-10-15 et 2026-10-16)

MesureValeurContexte
Évaluation29/30 (97 %), seuil 90 %gemini-3.5-flash-lite, API Gemini (15/10) puis Vertex AI global (16/10), même cas en échec
Latence d'un tour d'agentp50 1,8 s, p95 3,1 s (API Gemini) ; p50 2,2 s, p95 3,3 s (Vertex AI)outils et recherche compris
Coût modèle0,036 les30conversations,0,0012les 30 conversations, 0,0012 par conversationprix publics de l'API Gemini
Cloud Runscénario de bout en bout : 10 contrôles sur 10Vertex AI, global, gemini-3.5-flash-lite (16/10)
Cloud Run, europe-west13 contrôles sur 10 en échec, tour le plus lent 14,7 serreurs 429 sur quota partagé, gemini-2.5-flash, voir leçon 8

Stack et prérequis

Python 3.10+, Google ADK 2.10, google-genai, FastAPI, SQLite, HTML/CSS/JS sans framework, Docker (facultatif), gcloud pour la dernière leçon. Il faut savoir lire du Python asynchrone et avoir déjà écrit un agent ADK avec un outil ; les labs ADK de la plateforme suffisent.

Coût estimé : moins de 0,10 $ d'appels Gemini pour tout le parcours (e2e et évaluation comprises), quelques centimes de Cloud Build et Cloud Run pour le déploiement, à condition de lancer make cloud-down.

Programme

#LeçonVous finissez avec
1Le problème et l'architecturemake test vert, l'application lancée
2RAG sur la FAQ et les CGVune recherche qui retrouve le bon article
3Outils commande, suivi, retourun retour créé, une fuite de données bloquée
4Canaux web et WhatsAppun webhook signé, idempotent, simulé
5Escalade et repriseune conseillère qui reprend puis rend la main
6Tableau de bord temps réelcoût, latence et résolution en direct
7Évaluation sur 30 conversationsmake eval avec seuil bloquant
8Déployer sur Cloud Run, puis nettoyerun service testé, puis supprimé et vérifié

En local ou sur Google Cloud

Les leçons 1 à 7 tournent sur votre poste avec une clé d'API Gemini (ou sans clé pour make test). La leçon 8 demande un projet Google Cloud avec facturation.

Et les produits existants ?

Des produits couvrent déjà ce besoin. Watpilot, par exemple, est un assistant IA pour WhatsApp Business qui répond aux clients, prend des commandes et transfère à un humain avec l'historique. Ce projet n'est pas Watpilot et n'en reproduit pas le fonctionnement interne : c'est un dépôt pédagogique qui expose chaque mécanisme (webhook, identité, RAG, escalade, mesure) pour que vous sachiez évaluer un tel produit, ou en construire un.

Kit de publication LinkedIn

Le post, le carrousel et la vidéo de démo, prêts à publier une fois le projet réalisé.

Le post

Post LinkedIn (prêt à publier)

Un agent de support client n'est pas jugé sur ses bonnes réponses. Il est jugé sur le moment où il passe la main, et sur ce qu'il fait quand le modèle ne répond plus.

J'ai construit un agent de support omnicanal complet pour une boutique fictive de linge de maison, puis je l'ai mesuré.

Ce qu'il fait :

  • répond sur un widget web et sur un canal WhatsApp simulé (webhooks signés au format de l'API WhatsApp Business Cloud) ;
  • répond sur la FAQ et les conditions de vente par recherche sémantique (RAG) ;
  • consulte une commande, suit un colis, crée un retour, avec vérification d'identité ;
  • transfère à un conseiller avec une file par priorité, puis reprend la conversation quand l'humain rend la main ;
  • alimente un tableau de bord en temps réel : conversations, taux de résolution sans humain, escalades, latence, coût.

Les chiffres, mesurés le 15 octobre 2026 avec gemini-3.5-flash-lite :

  • 29 conversations de référence réussies sur 30 (seuil bloquant à 27) ;
  • latence d'un tour d'agent : 1,8 s en médiane, 3,1 s au 95e centile ;
  • coût modèle : 0,036 $ pour les 30 conversations, soit environ 0,1 centime par conversation ;
  • 18 tests automatisés qui tournent sans clé ni réseau.

Ce que le déploiement sur Cloud Run m'a appris :

  1. Sur un projet au quota Vertex AI partagé, des erreurs 429 arrivent. L'agent ne laisse jamais le client sans réponse : le tour en échec part dans la file d'un conseiller.
  2. Meta relance les webhooks non acquittés. Le service répond 200 immédiatement, traite en tâche de fond et ignore les doublons grâce à l'identifiant du message.
  3. Quand un conseiller rend la main, l'agent n'a rien vu de l'échange. Il reçoit donc en contexte tout ce qui s'est dit entre-temps, et retient l'engagement pris par l'humain.

Le seul échec de l'évaluation venait du jeu de test, pas de l'agent : il avait transféré une demande de modification de commande à un conseiller, exactement ce que prévoit la FAQ.

Sur ce créneau, des produits existent déjà, comme Watpilot pour WhatsApp Business. Ce projet n'en est pas un clone : c'est un dépôt pédagogique qui montre les mécanismes de bout en bout, du webhook à la facture.

Stack : Google ADK, Gemini (API et Vertex AI), FastAPI, SQLite, HTML/CSS/JS sans framework, Cloud Run. Code complet, tests, évaluation et formation pas à pas sur Atelier, rubrique Projets vitrine.

#IA #ServiceClient #GoogleADK #Gemini #CloudRun


Pièces jointes :

  • carrousel : carrousel-1.png à carrousel-5.png (1080x1350), source carrousel.html
  • vidéo : demo.mp4 (22 s, enregistrement réel de la démo)
post.md

Ressources

Tout télécharger (.zip)

Références